
Example of dynamic thresholds per dimension
В Grafana Alerting каждое правило оповещения поддерживает только одно выражение условия.
Во многих случаях этого достаточно — большинство оповещений используют фиксированный числовой порог, такой как latency > 3s или error_rate > 5%, чтобы определять своё состояние.
По мере роста вашей системы оповещений вы можете обнаружить, что разным целям требуются разные значения порогов.
Вместо дублирования правил оповещения вы можете назначить разное значение порога для каждой цели, сохраняя одно и то же условие. Это упрощает поддержку оповещений.
В этом примере показано, как это сделать с помощью многомерных оповещений и выражения Math.
Example overview
Вы отслеживаете задержку нескольких API-сервисов. Изначально вы хотите получать оповещения, если задержка 95-го процентиля (p95_api_latency) превышает 3 секунды, поэтому ваше правило оповещения использует один статический порог:
p95_api_latency > 3Но команда быстро обнаруживает, что некоторые сервисы требуют более строгих порогов. Например, задержка для платёжных API должна оставаться ниже 1,5 с, в то время как фоновые задачи могут допускать до 5 с. Команда устанавливает разные пороги для каждого сервиса:
p95_api_latency{service="checkout-api"}: должен оставаться ниже1.5s.p95_api_latency{service="auth-api"}: также строгий,1.5s.p95_api_latency{service="catalog-api"}: менее критичный,3s.p95_api_latency{service="async-tasks"}: фоновые задачи могут допускать до5s.
Вы хотите избежать создания одного правила оповещения на каждый сервис — это сложнее поддерживать.
В Grafana Alerting вы можете определить одно правило оповещения, которое отслеживает множество похожих компонентов, как в этом сценарии. Это называется многомерными оповещениями: одно правило оповещения, много экземпляров оповещений — по одному на каждый уникальный набор меток.
Но есть проблема: Grafana поддерживает только одно условие оповещения на правило.
One alert rule
├─ One condition ( e.g., $A > 3)
│  └─ Applies to all returned series in $A
│     ├─ {service="checkout-api"}
│     ├─ {service="auth-api"}
│     ├─ {service="catalog-api"}
│     └─ {service="async-tasks"}
Чтобы оценивать пороги по каждому сервису, вам нужно отдельное значение порога для каждой возвращаемой серии.
Dynamic thresholds using a Math expression
Вы можете создать динамическое условие оповещения, работая с двумя запросами с помощью выражения Math.
$Aдля результатов запроса (например,p95_api_latency).$Bдля порогов по каждому сервису (из данных CSV или другого запроса).$A > $B— это выражение Math, определяющее условие оповещения.
Grafana оценивает выражение Math по каждой серии, объединяя серии из $A и $B на основе их общих меток перед применением выражения.
Вот пример арифметической операции:
$Areturns series{host="web01"} 30and{host="web02"} 20.$Breturns series{host="web01"} 10and{host="web02"} 0.$A + $Breturns{host="web01"} 40and{host="web02"} 20.
На практике вы должны согласовать ваш входной порог с наборами меток, возвращаемыми вашим запросом оповещения.
Следующая таблица иллюстрирует, как порог по каждому сервису оценивается в предыдущем примере:
В этом примере:
$Aберётся из запросаp95_api_latency.$Bзадаётся вручную со значением порога для каждой серии в$A.- Условие оповещения сравнивает
$A>$B, используя реляционный оператор Math (например,>,<,>=,<=,==,!=), который объединяет серии по совпадающим меткам. - Grafana оценивает условие оповещения и устанавливает состояние firing там, где условие истинно.
Выражение Math работает до тех пор, пока каждую серию в $A можно сопоставить ровно с одной серией в $B. Они должны совпадать таким образом, чтобы получить взаимно однозначное соответствие между сериями в $A и $B.
Caution
Если серия в одном запросе не совпадает ни с одной серией в другом, она исключается из результата и отображается предупреждающее сообщение:
1 items dropped from union(s): ["$A > $B": ($B: {service=payment-api})]
Метки в обеих сериях не обязательно должны быть идентичными. Если метки одной являются подмножеством другой, они могут объединиться. Например:
$Aвозвращает серии{host="web01", job="event"}30 и{host="web02", job="event"}20.$Bвозвращает серии{host="web01"}10 и{host="web02"}0.$A+$Bвозвращает{host="web01", job="event"}40 и{host="web02", job="event"}20.
Try it with TestData
Вы можете использовать источник данных TestData, чтобы воспроизвести этот пример:
-
Добавьте источник данных TestData через меню Connections.
-
Создайте правило оповещения.
Перейдите в Alerting → Alert rules и нажмите New alert rule.
-
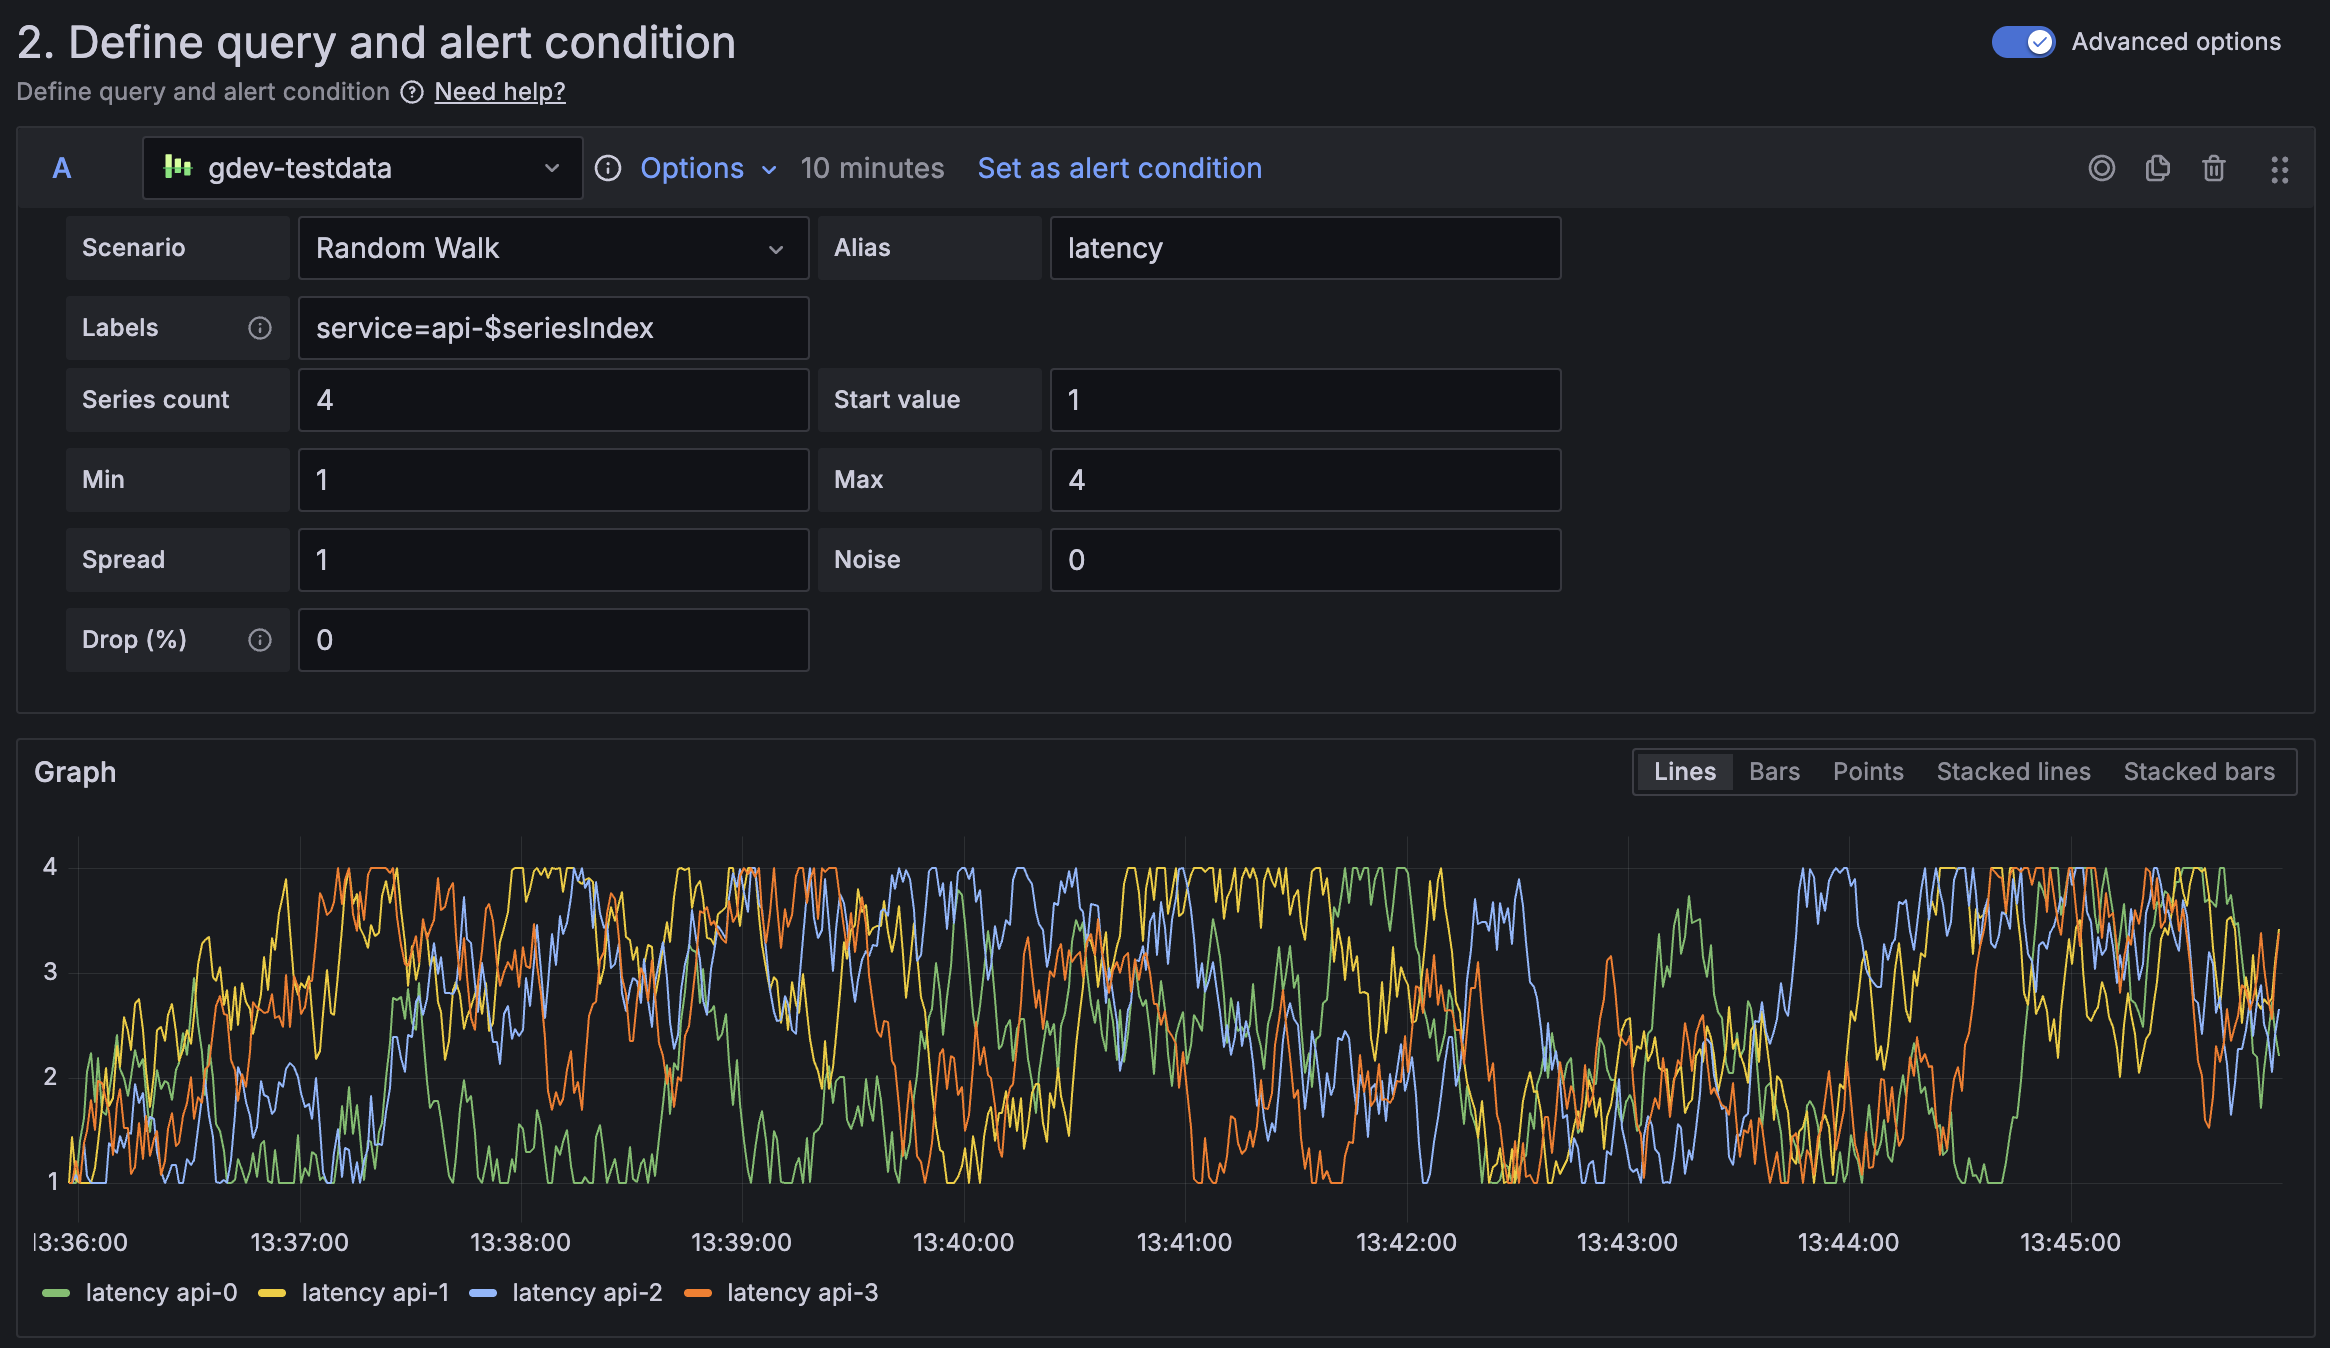
Имитируйте запрос (
$A), который возвращает задержки по каждому сервису.Выберите TestData в качестве источника данных и настройте сценарий.
-
Scenario: Random Walk
-
Alias: latency
-
Labels: service=api-$seriesIndex
-
Series count: 4
-
Start value: 1
-
Min: 1, Max: 4
Здесь
$seriesIndexиспользуется для назначения уникальных меток сервисов:api-0,api-1и т. д.
![TestData data source returns 4 series to simulate latencies for distinct API services.]()
-
-
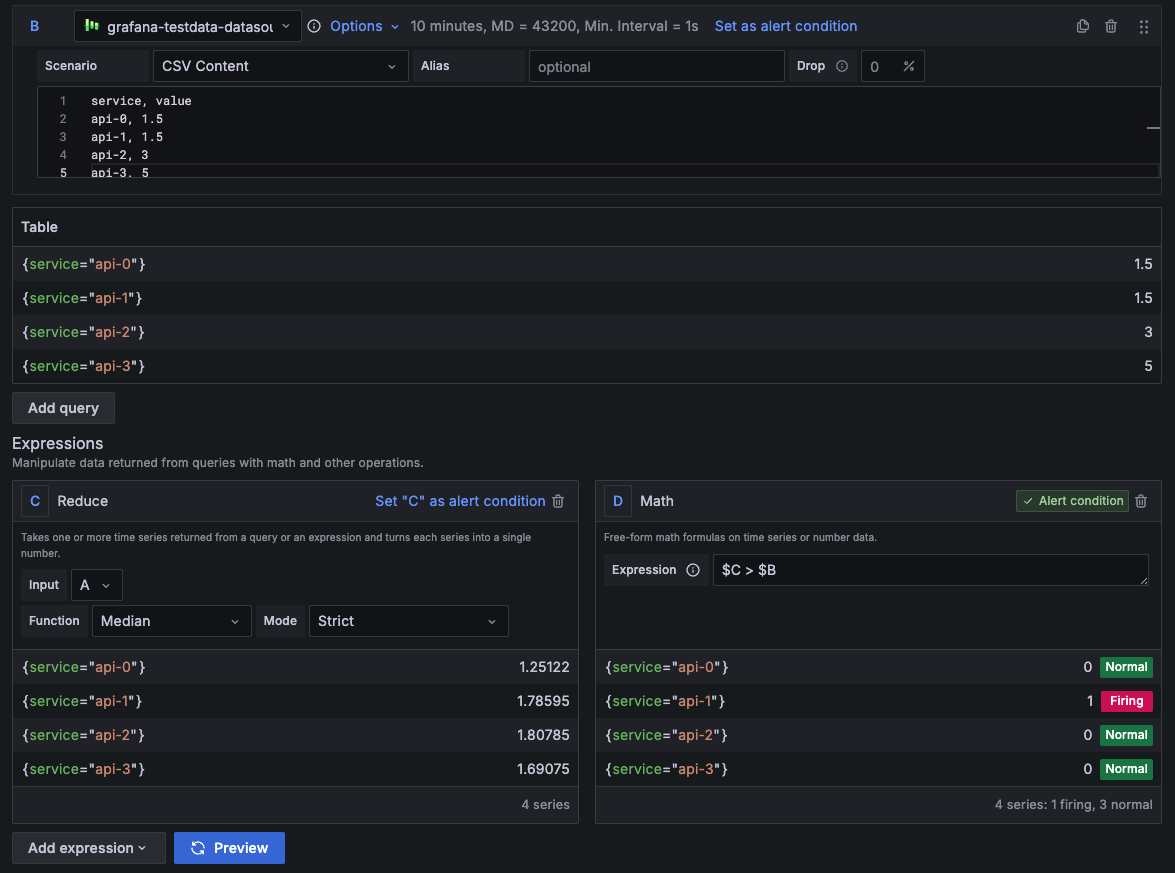
Определите пороги по каждому сервису с помощью статических данных.
Добавьте новый запрос (
$B) и выберите TestData в качестве источника данных.В поле Scenario выберите CSV Content и вставьте этот CSV:
 service,value
 api-0,1.5
 api-1,1.5
 api-2,3
 api-3,5
Столбец
serviceдолжен соответствовать меткам из$A.Столбец
value— это числовое значение, используемое для сравнения в оповещении.Подробности о требованиях к формату CSV см. в примерах табличных данных.
-
Добавьте новое выражение Reduce (
$C).- Type: Reduce
- Input: A
- Function: Mean
- Name: C
Это вычисляет среднюю задержку для каждого сервиса:
api-0,api-1и т. д. -
Добавьте новое выражение Math.
- Type: Math
- Expression:
$C > $B - Задайте это выражение как условие оповещения.
Оно срабатывает, если средняя задержка (
$C) превышает порог из$Bдля любого сервиса. -
Предварительно просмотрите оповещение.

Alert preview evaluating multiple series with distinct threshold values Tip
Вы можете изучить этот пример оповещений в Grafana Play.
Откройте пример, чтобы увидеть результаты оценки оповещений, созданные экземпляры оповещений, временную шкалу истории оповещений и сведения о правилах оповещения.
Other use cases
Этот пример показал, как построить одно правило оповещения с разными порогами для каждой серии с помощью многомерных оповещений и выражений Math.
Такой подход хорошо масштабируется при мониторинге похожих компонентов с разными целями по надёжности.
Сопоставляя серии из двух запросов, вы можете применять динамический порог — одно значение на каждый набор меток — без дублирования правил.
Хотя в этом примере для определения порогов используются статические данные CSV, та же техника работает и в других сценариях:
- Динамические пороги из запросов или recording rules: Получайте значения порогов из запроса к реальному времени или из пользовательских recording rules.
- Комбинирование нескольких условий: Стройте более продвинутую логику порогов, комбинируя несколько условий — таких как задержка, частота ошибок или объём трафика.
Например, вы можете определить выражение PromQL, которое задаёт порог задержки, корректируемый в зависимости от трафика, позволяя более высокое время отклика в периоды высокой нагрузки.
(
  // Fires when p95 latency > 2s during usual traffic (≤ 1000 req/s)
  service:latency:p95 > 2 and service:request_rate:rate1m <= 1000
)
or
(
  // Fires when p95 latency > 4s during high traffic (> 1000 req/s)
  service:latency:p95 > 4 and service:request_rate:rate1m > 1000
)