
Examples of trace-based alerts
Метрики — это основа большинства систем оповещения. Обычно они являются первым сигналом о том, что что-то не так, но они не всегда указывают где или почему происходит сбой.
Трейсы заполняют этот пробел, показывая полный путь, который проходит запрос через вашу систему. Они отображают рабочие процессы между сервисами, указывая, где запрос замедляется или даёт сбой.
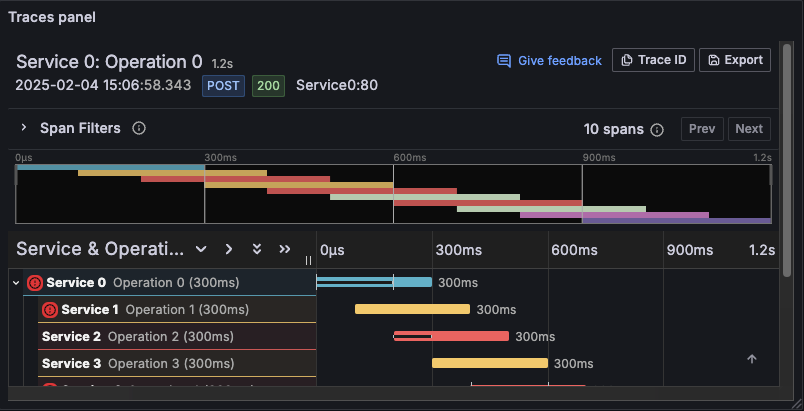
Трейсы сообщают длительность и ошибки напрямую для конкретных сервисов и спанов, помогая найти затронутый компонент и область сервиса. С этим дополнительным контекстом оповещения по данным трассировки могут помочь вам быстрее выявлять первопричины.
Вы можете создавать оповещения на основе трейсов в Grafana Alerting, используя два основных подхода:
- Запрос метрик, генерируемых из данных трассировки.
- Использование TraceQL, языка запросов для трейсов, доступного в Grafana Tempo.
Это руководство содержит вводные примеры и различные подходы к настройке оповещений на основе трейсов в Grafana. Данные трассировки обычно собираются с помощью инструментирования OpenTelemetry (OTel). OTel позволяет интегрировать данные трассировки из широкого спектра приложений и сред в Grafana.
Alerting on span metrics
OpenTelemetry предоставляет процессоры, которые преобразуют данные трассировки в метрики в стиле Prometheus.
Процессоры service graph и span metrics — это стандартные опции в Alloy и Tempo для генерации метрик Prometheus из трейсов. Они могут генерировать метрики rate, error и duration (RED) из выборочных спанов.
Затем вы можете создавать правила оповещения, которые запрашивают метрики, производные от трейсов.
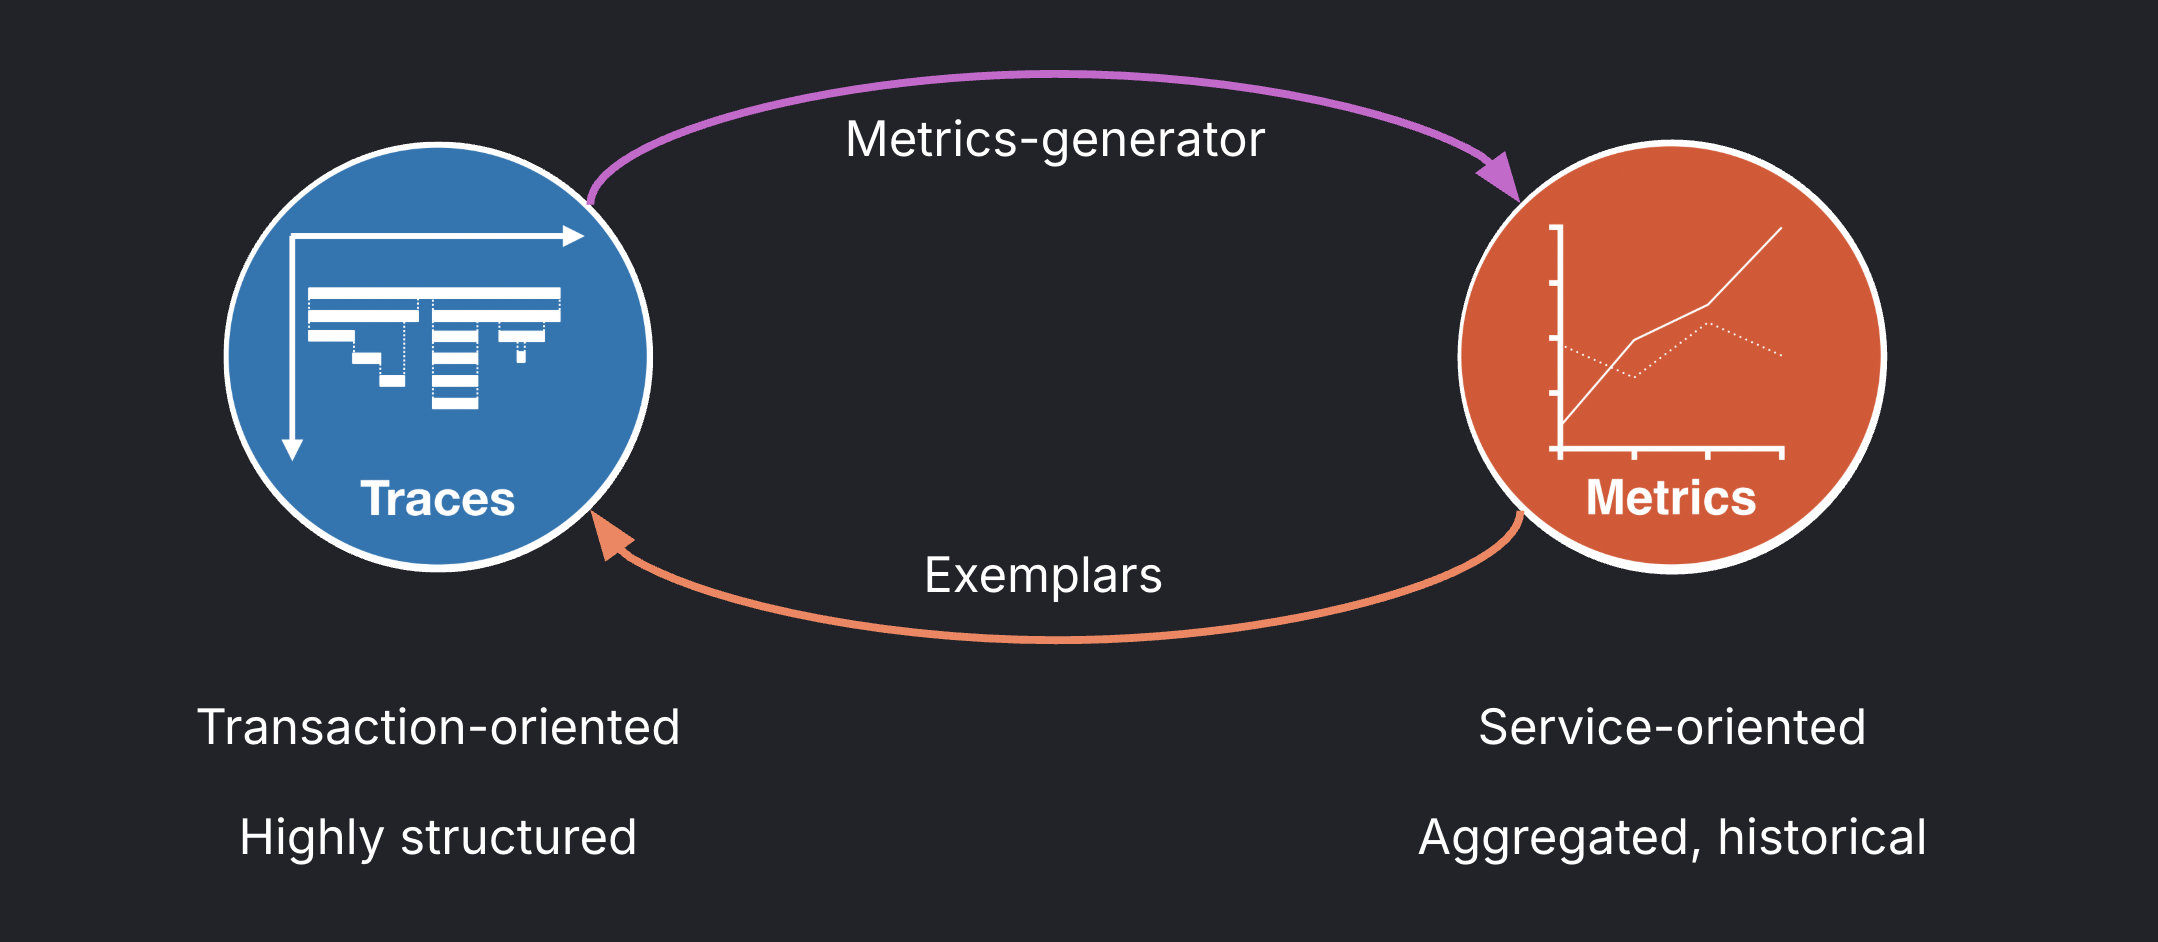
Метрики service graph сосредоточены на взаимодействии между сервисами и работоспособности зависимостей. Они измеряют вызовы между сервисами, помогая Grafana выводить топологию сервисов. Однако они измеряют только взаимодействие между двумя сервисами — они не включают внутреннее время обработки сервиса-клиента.
Вы можете использовать метрики service graph для обнаружения инфраструктурных проблем, таких как деградация сети или проблемы с service mesh.
Для оповещений на основе трейсов используйте span metrics.
Span metrics измеряют общее время обработки запроса к сервису: они фиксируют то, что происходит внутри сервиса, а не только взаимодействие между сервисами. Они включают время, затраченное на внутреннюю обработку и ожидание нижестоящих вызовов, предоставляя сквозную картину производительности сервиса.
В зависимости от того, как вы создаёте span metrics, генерируются следующие span metrics:
Каждая метрика по умолчанию включает следующие метки: service, span_name, span_kind, status_code, status_message, job и instance.
В генераторе метрик вы можете настроить, как трейсы преобразуются в метрики, сконфигурировав гистограммы, exemplars, измерения метрик и другие параметры.
Следующие примеры предполагают, что span metrics уже сгенерированы с использованием одной из этих опций или альтернативы.
Detect slow span operations
Этот пример показывает, как определить правило оповещения, которое обнаруживает, когда операции, обрабатываемые сервисом, становятся медленными.
Прежде чем смотреть на запрос, полезно ознакомиться с несколькими элементами трейса, которые определяют его работу:
- Трейс представляет один запрос или транзакцию, проходящую через несколько спанов и сервисов. Спан относится к конкретной операции внутри сервиса.
- Каждый спан включает имя операции (
span_name) и её длительность (значение метрики), а также дополнительные поля, такие как статус спана (status_code) и вид спана (span_kind). - Спан сервера представляет работу, выполняемую на принимающей стороне запроса, тогда как спан клиента представляет исходящий вызов (родительский спан), ожидающий ответа (клиент → сервер).
Чтобы обнаруживать медленные входящие операции в конкретном сервисе, вы можете определить правило оповещения, которое обнаруживает, когда процентильная задержка спанов сервера превышает порог. Например:
Обнаруживать, когда 95 % запросов (исключая ошибки) не завершаются быстрее 2 секунд.
Using native histograms
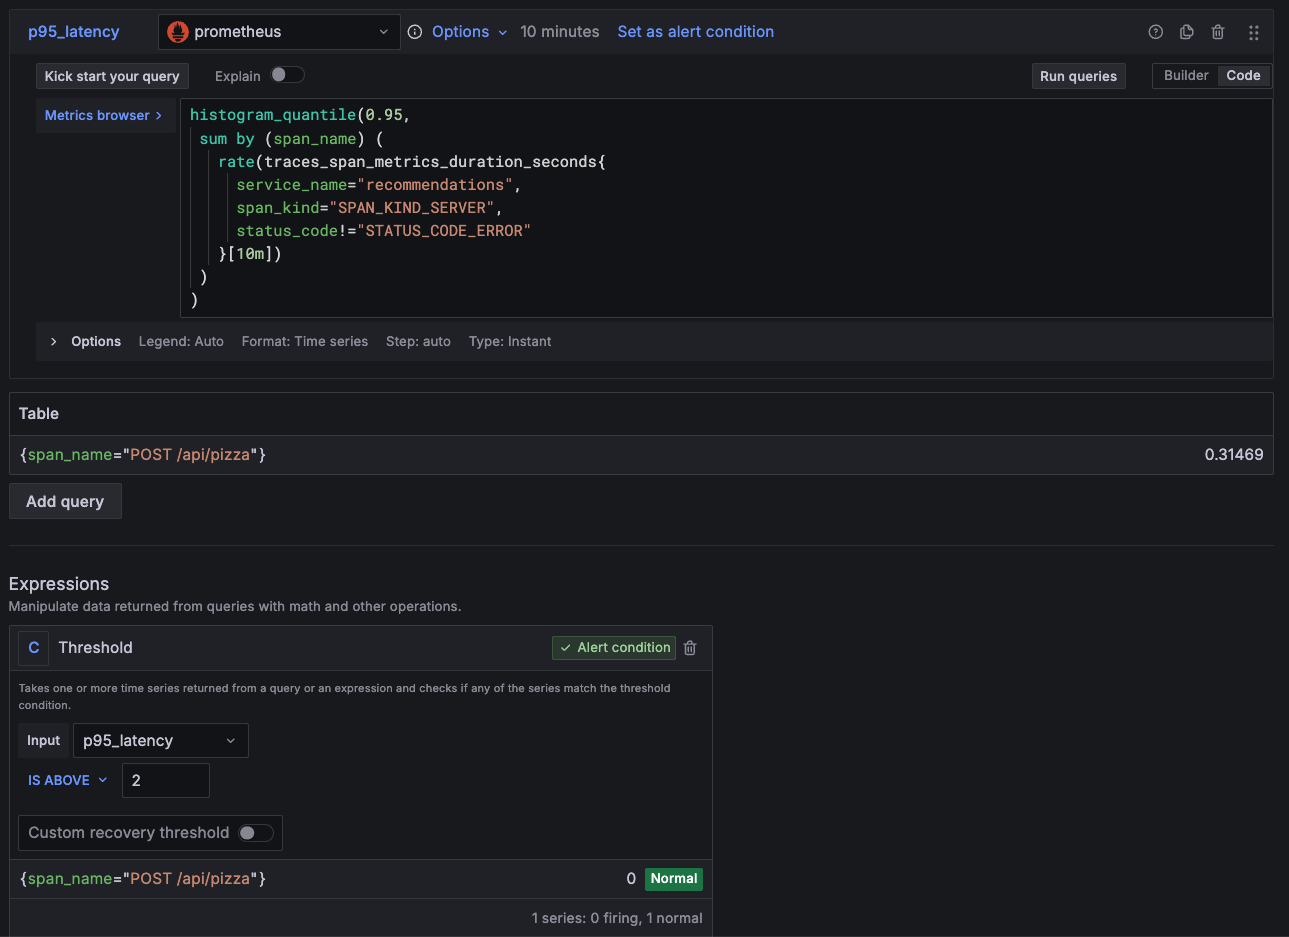
Следующий запрос PromQL использует метрику нативной гистограммы traces_span_metrics_duration_seconds для определения запроса правила оповещения.
histogram_quantile(0.95,
 sum by (span_name) (
   rate(traces_span_metrics_duration_seconds{
     service_name="<SERVICE_NAME>",
     span_kind="SPAN_KIND_SERVER",
     status_code!="STATUS_CODE_ERROR"
   }[10m])
 )
) > 2
Разбор запроса:
-
traces_span_metrics_duration_secondsЭто нативная гистограмма, созданная из спанов с помощью Alloy или коллектора OTEL. Метрика фильтруется по:service_name="<SERVICE_NAME>"нацеливается на конкретный сервис.span_kind="SPAN_KIND_SERVER"выбирает спаны, обрабатывающие входящие запросы.status_code!="STATUS_CODE_ERROR"исключает спаны, завершившиеся с ошибкой.
Вам следует запрашивать
traces_spanmetrics_latencyпри использовании других генераторов span metrics. -
rate(...[10m])Преобразует гистограмму в посекундную гистограмму за последние 10 минут (распределение спанов в секунду за этот период). Это делает временное окно явным и гарантирует, что задержки можно вычислить за последние 10 минут с помощью функцийhistogram_*. -
sum by (span_name)( … )Объединяет все серии с одинаковымspan_name. Это создаёт многомерное оповещение, которое генерирует один экземпляр оповещения на каждое имя спана (операцию). -
histogram_quantile(0.95, ...)Вычисляет задержку p95 из гистограммы после применения rate. Запрос выполняется как мгновенный запрос Prometheus, возвращая одно значение за 10-минутное окно. -
> 2Определяет условие порога. Он возвращает только серии, чья задержка p95 превышает 2 секунды. Либо вы можете задать этот порог как выражение Grafana Alerting в интерфейсе, как показано на следующем скриншоте.
Alert rule querying span metrics and using threshold expression
Using classic histograms
Нативные гистограммы стабильны в Prometheus начиная с v3.8.0. Поэтому ваш генератор span metrics может создавать классические гистограммы для метрик задержки спанов — либо traces_span_metrics_duration_seconds, либо traces_spanmetrics_latency.
При использовании классических гистограмм метрика та же, но формат метрики меняется. Классическая гистограмма представляет гистограмму с фиксированными сегментами и предоставляет три метрики:
_bucket: накопительные сегменты наблюдений._sum: общая сумма всех наблюдаемых значений._count: количество наблюдаемых значений.
Чтобы точно вычислять процентили, особенно при превышении определённого порога (например, `2s`), вам нужно настроить классическую гистограмму с явным сегментом, например:
["100ms", "250ms", "1s", "2s", "5s"]otelcol.connector.spanmetrics может настраивать сегменты с помощью блока explicit. Генератор метрик в Tempo может настраивать параметр span_metrics.histogram_buckets.
Вот эквивалентный PromQL для классических гистограмм:
histogram_quantile(0.95,
 sum by (span_name, le) (
   rate(traces_span_metrics_duration_seconds_bucket{
     service_name="<SERVICE_NAME>",
     span_kind="SPAN_KIND_SERVER",
     status_code!="STATUS_CODE_ERROR"
   }[10m])
 )
) > 2
Ключевые отличия от примера с нативными гистограммами:
- Вы должны настроить сегмент гистограммы, соответствующий желаемому порогу (например,
2s). - Вы должны запрашивать метрику
_bucket, а не базовую метрику. - Вы должны включить
leв группировкуsum by (…)для вычисленияhistogram_quantile.
Всё остальное остаётся тем же.
Note
Правила оповещения в этих примерах создают многомерные оповещения: один экземпляр оповещения на каждое отдельное имя спана.
Динамические маршруты спанов, такие как
/product/1234, могут создавать отдельные измерения метрик и оповещения для каждого уникального спана, что может существенно повлиять на расходы на метрики и производительность при больших объёмах.Чтобы предотвратить появление данных с высокой кардинальностью, нормализуйте динамические маршруты, такие как
/product/{id}, используя семантические атрибуты, такие какhttp.routeиurl.template, и ограничьте измерения низкокардинальными полями, такими какservice_name,status_codeилиhttp_method.
Detect high error rate
Этот пример определяет правило оповещения, которое обнаруживает, когда частота ошибок для любой операции превышает 20 %. Вы можете использовать эти оповещения о частоте ошибок для выявления роста ошибок запросов, таких как ответы 5xx или внутренние сбои.
Следующий запрос вычисляет долю неудачных спанов сервера для каждого сервиса и операции.
(
  sum by (service, span_name) (
    rate(traces_span_metrics_calls_total{
      span_kind="SPAN_KIND_SERVER",
      status_code="STATUS_CODE_ERROR"
    }[10m])
  )
/
  sum by (service, span_name) (
    rate(traces_span_metrics_calls_total{
      span_kind="SPAN_KIND_SERVER"
    }[10m])
  )
) > 0.2
Разбор запроса
-
traces_span_metrics_calls_totalСчётчик, созданный из спанов, который отслеживает количество завершённых операций спанов.span_kind="SPAN_KIND_SERVER"выбирает спаны, обрабатывающие входящие запросы.status_code="STATUS_CODE_ERROR"выбирает только спаны, завершившиеся с ошибкой.- Пропуск фильтра
status_codeв знаменателе включает все спаны, возвращая общее количество спанов.
Проверьте, не создаёт ли ваш генератор метрик вместо этого метрику
traces_spanmetrics_calls_total, и скорректируйте имя метрики. -
rate(...[10m])Преобразует накопительную гистограмму в посекундную гистограмму за последние 10 минут (распределение спанов в секунду за этот период). Это делает временное окно явным и гарантирует, что счётчики можно вычислить за последние 10 минут. -
sum by (service, span_name)( … )Агрегирует по сервису и операции, создавая один экземпляр оповещения для каждой комбинации(service, span_name). Это многомерное оповещение, которое применяется ко всем сервисам, помогая определить, какой сервис и соответствующая операция дают сбой. -
sum by () (...) / sum by () (...)Делит неудачные спаны на общее количество спанов, чтобы вычислить частоту ошибок по операции. Результат — это отношение между0и1, где1означает, что все операции завершились с ошибкой. Запрос выполняется как мгновенный запрос Prometheus, возвращая одно значение за 10-минутное окно. -
> 0.2Определяет условие порога. Он возвращает только серии, чья частота ошибок превышает 20 % спанов. Либо вы можете задать этот порог как выражение Grafana Alerting в интерфейсе.
Enable traffic guardrails
Когда трафик очень низкий, даже один медленный или неудачный запрос может вызвать оповещения.
Чтобы избежать таких ложных срабатываний в периоды низкого трафика, вы можете включить условие минимального трафика в ваши запросы правил оповещения. Например:
sum by (service, span_name)(
  increase(traces_span_metrics_calls_total{
    span_kind="SPAN_KIND_SERVER"
  }[10m])
) > 300
Этот запрос возвращает только спаны, которые обработали более 300 запросов за 10-минутный период.
Этот минимальный уровень трафика помогает предотвратить ложные срабатывания, гарантируя, что оповещение оценивает значительное количество спанов перед срабатыванием.
Вы можете комбинировать это условие трафика с запросом error-rate, чтобы оповещения срабатывали только тогда, когда выполнены оба условия:
((
  sum by (service, span_name) (
    rate(traces_span_metrics_calls_total{
      span_kind="SPAN_KIND_SERVER",
      status_code="STATUS_CODE_ERROR"
    }[10m])
  )
/
  sum by (service, span_name) (
    rate(traces_span_metrics_calls_total{
      span_kind="SPAN_KIND_SERVER"
    }[10m])
  )
) > 0.2)
and
(
    sum by (service, span_name)(
    increase(traces_span_metrics_calls_total{
      span_kind="SPAN_KIND_SERVER"
    }[10m])
) > 300 )
Для данного спана оповещение срабатывает, когда:
- Частота ошибок превышает 20 % за последние 10 минут.
- Спан обработал не менее 300 запросов за последние 10 минут.
Либо вы можете разделить оповещение на отдельные запросы и объединить их с помощью математического выражения в качестве порога. В приведённом ниже примере $ErrorRateCondition — это ссылка Grafana для запроса частоты ошибок, а $TrafficCondition — ссылка для запроса трафика.
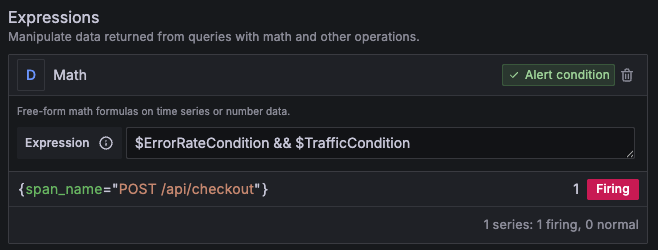
В этом случае вы должны убедиться, что оба запроса группируются по одинаковым меткам.
Преимущество этого подхода в том, что вы можете наблюдать результаты обоих независимых запросов. Затем вы можете получить доступ к результатам запросов через переменную $values и отображать их в уведомлениях или использовать в пользовательских метках.
Потенциальный недостаток разделения запросов — каждый запрос выполняется отдельно. Это увеличивает нагрузку на бэкенд и может повлиять на производительность запросов, особенно в средах с большим количеством активных оповещений.
Вы можете применить этот шаблон ограждения трафика к любому правилу оповещения.
Consider sampling
Сэмплирование — это техника, используемая для сокращения объёма собранных спанов в целях экономии. Существуют две основные стратегии, которые можно комбинировать:
- Head sampling: Решение о записи или отбрасывании спана принимается при начале трейса. Условие можно настроить вероятностно (процент трейсов) или путём фильтрации определённых операций.
- Tail sampling: Решение принимается после завершения трейса. Это позволяет сэмплировать более интересные операции, такие как медленные или неудачные запросы.
При head sampling оповещения по span metrics следует настраивать с осторожностью, поскольку span metrics будут представлять только подмножество всех трейсов.
При tail sampling важно генерировать span metrics до принятия решения о сэмплировании. Grafana Cloud Adaptive Traces делают это автоматически. При использовании Alloy или OpenTelemetry Collector убедитесь, что коннектор SpanMetrics выполняется до фильтрации или процессора tail sampling.
Using TraceQL
TraceQL — это язык запросов для поиска и фильтрации трейсов в Grafana Tempo, использующий синтаксис, похожий на PromQL и LogQL.
С TraceQL вы можете пропустить преобразование данных трассировки в span metrics и напрямую запрашивать необработанные данные трассировки. Он обеспечивает более гибкую фильтрацию на основе структуры трейса, атрибутов или метаданных ресурсов и может обнаруживать проблемы быстрее, так как не ждёт генерации метрик.
TraceQL подходит не для всех сценариев. Например:
-
Не подходит для долгосрочного анализа Данные трассировки имеют значительно более короткий срок хранения, чем метрики. Для исторического мониторинга рекомендуется преобразовывать ключевые данные трассировки в метрики, чтобы обеспечить сохранность важных данных.
-
Не подходит для оповещений после сэмплирования TraceQL может запрашивать только трейсы, которые фактически хранятся в Tempo. Если сэмплирование отбрасывает большую часть трейсов, оповещения на основе TraceQL могут пропустить реальные проблемы. Руководство о том, как генерировать span metrics до сэмплирования, см. в разделе consider sampling.
Caution
Оповещения с TraceQL доступны в Grafana v12.1 или выше и поддерживаются как функция частного предпросмотра. Инженерная поддержка и поддержка on-call недоступны. SLA не предоставляется.
Хотя TraceQL может быть мощным инструментом для исследования и обнаружения проблем непосредственно по данным трассировки, оповещения с TraceQL пока не следует использовать в production-средах. На данный момент используйте их для тестирования и экспериментов.
Следующий пример демонстрирует, как воссоздать предыдущее правило оповещения, которое обнаруживало медленные операции спанов, с помощью TraceQL.
Выполните следующие шаги, чтобы создать оповещение:
-
Включите оповещения TraceQL Чтобы использовать TraceQL в оповещениях, вы должны включить флаг функции
tempoAlertingв вашей конфигурации Grafana.Если вы используете Grafana Cloud, обратитесь в Support, чтобы включить оповещения TraceQL.
-
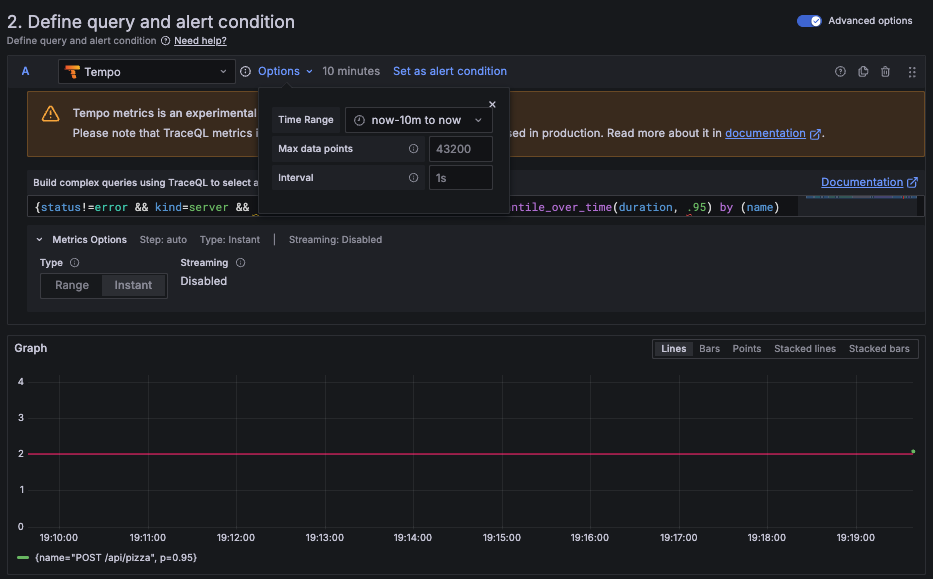
Настройте запрос оповещения
В вашем правиле оповещения выберите источник данных Tempo, затем преобразуйте исходный запрос PromQL в эквивалентный запрос TraceQL:
{status != error && kind = server && .service.name = "<SERVICE_NAME>"}
| quantile_over_time(duration, .95) by (name)
Для данного сервиса этот запрос вычисляет задержку p95 для всех спанов сервера, исключая ошибки, и группирует их по имени спана.
-
Настройте диапазон времени
В настоящее время оповещения TraceQL поддерживают только range-запросы. Чтобы определить временное окно, задайте диапазон времени запроса как последние 10 минут.
-
From:
now-10m -
To:
now![Time range configuration for TraceQL alert rule]()
-
-
Добавьте выражение редуктора.
Range-запросы возвращают данные временных рядов, а не одно значение. Затем правило оповещения должно свести данные временных рядов к одному числовому значению, прежде чем сравнивать его с порогом.
Добавьте выражение Reduce, чтобы преобразовать результаты запроса в одно значение.
-
Задайте условие порога.
Создайте выражение Threshold, чтобы оно срабатывало, когда задержка p95 превышает 2 секунды: $B > 2.
![Alert rule configuration showing reducer and threshold expressions for TraceQL query]()
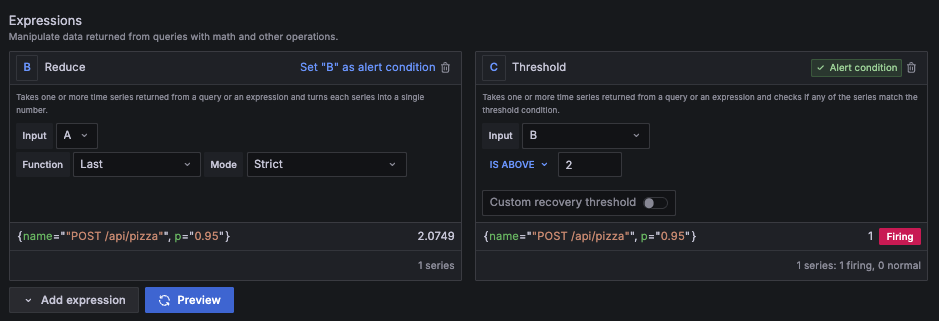
Это итоговое оповещение обнаруживает, когда 95 % спанов сервера для конкретного сервиса (исключая ошибки) занимают более 2 секунд на завершение, используя необработанные данные трассировки вместо span metrics.
Additional resources
Чтобы изучить связанные темы и расширить примеры в этом руководстве, см. следующие ресурсы:
-
Структура трейса: Узнайте, как структурированы трейсы и спаны.
-
Документация Grafana Tempo: Полный справочник по бэкенду трассировки с открытым исходным кодом от Grafana.
-
Span metrics с использованием генератора метрик в Tempo: Генерируйте span metrics напрямую из трейсов с помощью встроенного генератора метрик Tempo.
-
Span metrics с использованием Grafana Alloy: Настройте Alloy для экспорта span metrics из трейсов OpenTelemetry (OTel).
-
Многомерные оповещения: Узнайте, как вызывать несколько экземпляров оповещений на одно правило оповещения, как в этих примерах.
-
Документация Grafana SLO: Используйте span metrics для определения целей уровня обслуживания (SLO) в Grafana.
-
Сэмплирование трейсов: изучите стратегии и конфигурацию в Grafana Tempo.
Note
Инструментирование OpenTelemetry может записывать метрики независимо от спанов.
Эти метрики OTEL не являются производными от трейсов и не подвержены влиянию сэмплирования. Они могут служить альтернативой метрикам, производным от спанов.