 Grafana
Документация GlaberGraph
Оповещения
Дополнительная конфигурация
Настройка высокой доступности
Configure high availability
Grafana Alerting использует модель Prometheus, разделяющую оценку правил оповещения и доставку уведомлений. В этой модели оценка правил оповещения выполняется в генераторе оповещений, а доставка уведомлений — в получателе оповещений. В Grafana Alerting генератором оповещений является Scheduler, а получателем — Alertmanager.
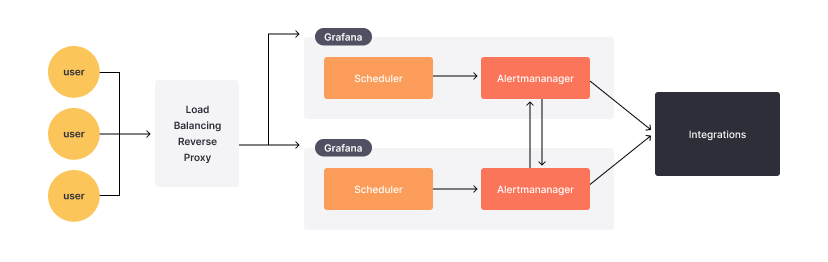
При запуске нескольких экземпляров Grafana все правила оповещения по умолчанию оцениваются на всех экземплярах. Можно считать, что оценка правил оповещения дублируется столько раз, сколько запущено экземпляров Grafana. Так Grafana Alerting гарантирует, что пока работает хотя бы один экземпляр Grafana, правила оповещения продолжают оцениваться и уведомления об оповещениях продолжают отправляться.
Если вы хотите сократить это дублирование, вы можете включить режим оценки на одном узле, чтобы правила оповещения оценивал только один экземпляр.
Это дублирование видно в истории состояний, и это хороший способ проверить вашу конфигурацию высокой доступности.
Хотя генератор оповещений оценивает все правила оповещения на всех экземплярах, получатель оповещений предпринимает все возможные усилия для предотвращения дублирующихся уведомлений. Alertmanager используют протокол gossip для обмена информацией между собой, чтобы предотвратить отправку дублирующихся уведомлений.
Alertmanager выбирает доступность вместо согласованности, что может привести к периодическим дублирующимся или неупорядоченным уведомлениям. Он придерживается мнения, что дублирующиеся или неупорядоченные уведомления лучше, чем отсутствие уведомлений.
Alertmanager также передают через gossip silences, то есть silence, созданный на одном экземпляре Grafana, реплицируется на все остальные экземпляры Grafana. Как уведомления, так и silences периодически сохраняются в базу данных, а также при корректном завершении работы.
Enable alerting high availability using Memberlist
Перед началом
Поскольку для gossip-обмена уведомлениями и silences используются как TCP-, так и UDP-порт 9094, убедитесь, что каждый экземпляр Grafana может принимать входящие соединения на этих портах.
Чтобы включить поддержку высокой доступности:
- В вашем файле пользовательской конфигурации ($WORKING_DIR/conf/custom.ini) перейдите в раздел
[unified_alerting]. - Задайте
[ha_peers]как количество хостов для каждого экземпляра Grafana в кластере (в формате host:port), например,ha_peers=10.0.0.5:9094,10.0.0.6:9094,10.0.0.7:9094. В разделеha_peersдолжен быть добавлен как минимум один (1) экземпляр Grafana. - Задайте
[ha_listen_address]как IP-адрес экземпляра в форматеhost:port(или IP-адрес пода, если используется Kubernetes). По умолчанию установлено прослушивание всех интерфейсов (0.0.0.0). - Задайте
[ha_advertise_address]как имя хоста или IP-адрес экземпляра в формате «host:port». Используйте эту настройку, когда экземпляр находится за NAT (Network Address Translation), например, в Docker Swarm или сервисе Kubernetes, где внешние и внутренние адреса различаются. Этот адрес помогает другим экземплярам кластера взаимодействовать с ним. Настройка необязательная. - Задайте
[ha_peer_timeout]в разделе[unified_alerting]файла custom.ini, чтобы указать время ожидания, пока экземпляр отправит уведомление через Alertmanager. Значение по умолчанию — 15s, но оно может быть увеличено, если серверы Grafana находятся в разных географических регионах или если задержка сети между ними высокая.
Демонстрацию см. в этом примере с использованием Docker Compose.
Enable alerting high availability using Redis
В качестве альтернативы Memberlist вы можете настроить Redis для включения высокой доступности. Поддерживаются режимы Redis standalone, Redis Cluster и Redis Sentinel.
Note
Memberlist является предпочтительным вариантом для высокой доступности. Используйте Redis только в средах, где прямое взаимодействие между серверами Grafana невозможно, например, когда порты TCP или UDP заблокированы.
- Убедитесь, что у вас есть сервер Redis, поддерживающий pub/sub. Если вы используете прокси перед вашим кластером Redis, убедитесь, что прокси поддерживает pub/sub.
- В вашем файле пользовательской конфигурации ($WORKING_DIR/conf/custom.ini) перейдите в раздел
[unified_alerting]. - Задайте
ha_redis_addressкак адрес или адреса сервера Redis, к которым должна подключаться Grafana. Это может быть один адрес Redis при использовании Redis standalone или список адресов, разделённых запятыми, при использовании Redis Cluster или Sentinel. - Необязательно: задайте
ha_redis_cluster_mode_enabledвtrue, если вы используете Redis Cluster. - Необязательно: задайте
ha_redis_sentinel_mode_enabledвtrue, если вы используете Redis Sentinel. Также задайтеha_redis_sentinel_master_nameкак имя мастера Redis Sentinel. - Необязательно: задайте имя пользователя и пароль, если на сервере Redis включена аутентификация, с помощью
ha_redis_usernameиha_redis_password. - Необязательно: задайте имя пользователя и пароль, если аутентификация включена на Redis Sentinel, с помощью
ha_redis_sentinel_usernameиha_redis_sentinel_password. - Необязательно: задайте
ha_redis_prefixкак что-то уникальное, если вы планируете использовать сервер Redis совместно с несколькими экземплярами Grafana. - Необязательно: задайте
ha_redis_tls_enabledвtrueи настройте соответствующие поляha_redis_tls_*для защиты связи между Grafana и Redis с помощью Transport Layer Security (TLS). - Задайте
[ha_advertise_address]какha_advertise_address = "${POD_IP}:9094". Это требуется, если у экземпляра нет IP-адреса, входящего в RFC 6890, с маршрутом по умолчанию.
Демонстрацию см. в этом примере с использованием Docker Compose.
Enable alerting high availability using Kubernetes
-
Вы можете предоставить IP-адрес пода через переменную окружения с помощью определения контейнера.
env: - name: POD_IP valueFrom: fieldRef: fieldPath: status.podIP -
Добавьте порт 9094 в развёртывание Grafana:
ports: - name: grafana containerPort: 3000 protocol: TCP - name: gossip-tcp containerPort: 9094 protocol: TCP - name: gossip-udp containerPort: 9094 protocol: UDP -
Добавьте переменные окружения в развёртывание Grafana:
env: - name: POD_IP valueFrom: fieldRef: fieldPath: status.podIP -
Создайте headless-сервис, который возвращает IP-адрес пода вместо IP-адреса сервиса, что и требуется для
ha_peers:apiVersion: v1 kind: Service metadata: name: grafana-alerting namespace: grafana labels: app.kubernetes.io/name: grafana-alerting app.kubernetes.io/part-of: grafana spec: type: ClusterIP clusterIP: 'None' ports: - port: 9094 selector: app: grafana -
Убедитесь, что ваше развёртывание grafana имеет метку, соответствующую селектору, например
app:grafana: -
Добавьте в grafana.ini:
[unified_alerting]
enabled = true
ha_listen_address = "${POD_IP}:9094"
ha_peers = "grafana-alerting.grafana:9094"
ha_advertise_address = "${POD_IP}:9094"
ha_peer_timeout = 15s
ha_reconnect_timeout = 2m
Single-node evaluation mode
Note
Single-node evaluation mode is currently in public preview. Grafana Labs offers limited support, and breaking changes might occur prior to the feature being made generally available.
По умолчанию все экземпляры Grafana в кластере высокой доступности оценивают все правила оповещения. Это означает, что нагрузка от запросов на источники данных умножается на количество экземпляров Grafana. Режим оценки на одном узле изменяет это так, что только один экземпляр оценивает правила оповещения, снижая нагрузку от запросов с N раз до 1.
Чтобы включить режим оценки на одном узле, добавьте следующее в ваш раздел [unified_alerting]:
[unified_alerting]
ha_single_node_evaluation = true
Эта настройка требует настроенного кластера высокой доступности (либо Memberlist, либо Redis).
How it works
Кластер Grafana автоматически выбирает первичный экземпляр, отвечающий за оценку всех правил оповещения. Остальные экземпляры полностью пропускают оценку.
- Широковещательная рассылка оповещений: Первичный экземпляр рассылает сработавшие оповещения всем остальным экземплярам через канал связи кластера. Это гарантирует, что встроенный Alertmanager каждого экземпляра имеет актуальные оповещения, что необходимо для восстановления после сбоев и для того, чтобы API Alertmanager возвращал корректные данные на всех экземплярах.
- Автоматическое восстановление после сбоев: Когда первичный экземпляр становится недоступным, кластер перераспределяет позиции, и новый экземпляр становится ответственным за оценку. Во время восстановления после сбоя возникает кратковременный перерыв в оценках. Существующие состояния оповещений остаются в базе данных.
Tradeoffs
Monitor single-node evaluation mode
Вы можете проверить, что режим оценки на одном узле работает корректно, отслеживая следующие метрики.
Следующие метрики зависят от используемого вами HA-бэкенда:
Memberlist (gossip)
Redis
Tune alert broadcast queue size
Первичный экземпляр использует очередь сообщений для рассылки оповещений другим экземплярам. По умолчанию очередь вмещает до 200 сообщений. Если у вас большое количество правил оповещения, очередь может заполниться, что приведёт к отбрасыванию сообщений. Это можно обнаружить, отслеживая метрику потерь для вашего HA-бэкенда (см. таблицы метрик выше).
Чтобы увеличить размер очереди, добавьте следующее в ваш раздел [unified_alerting]:
[unified_alerting]
ha_single_evaluation_alert_broadcast_queue_size = 500
Значение по умолчанию — 200. Эта настройка применяется как к HA-бэкендам Memberlist, так и Redis.
Verify your high availability setup
При запуске нескольких экземпляров Grafana все правила оповещения по умолчанию оцениваются на каждом экземпляре. Эта многократная оценка правил оповещения видна в истории состояний и предоставляет простой способ проверить, что ваша конфигурация высокой доступности работает корректно.
Note
Если используется сочетание
execute_alerts=falseиexecute_alerts=trueна узлах HA, то, поскольку состояние оповещений не разделяется между экземплярами Grafana, экземпляры сexecute_alerts=falseне отображают никакого статуса оповещений.Настройки HA (
ha_peersи т. д.) применяются только к связи между alertmanager, синхронизации silences и попыткам избежать дублирующихся уведомлений, как описано во введении.
Вы также можете подтвердить вашу конфигурацию высокой доступности, отслеживая метрики Alertmanager, предоставляемые Grafana.
Note
Начиная с Grafana v12.4 эти метрики имеют префикс
grafana_(например,grafana_alertmanager_cluster_members). Если вы обновляетесь с более ранней версии, обновите ваши дашборды и правила оповещения соответствующим образом.
Вы можете подтвердить количество экземпляров Grafana в вашей конфигурации высокой доступности оповещений, запрашивая метрики grafana_alertmanager_cluster_members и grafana_alertmanager_peer_position.
Обратите внимание, что эти метрики высокой доступности оповещений предоставляются через конечную точку /metrics в Grafana и не собираются и не отображаются автоматически. Если у вас есть экземпляр Prometheus, подключённый к Grafana, добавьте scrape_config, чтобы собирать метрики Grafana, а затем запрашивайте эти метрики в Explore.
- job_name: grafana
  honor_timestamps: true
  scrape_interval: 15s
  scrape_timeout: 10s
  metrics_path: /metrics
  scheme: http
  follow_redirects: true
  static_configs:
    - targets:
        - grafana:3000
Дополнительную информацию о мониторинге метрик оповещений см. в разделе Мета-мониторинг Alerting. Демонстрацию см. в примерах высокой доступности оповещений с использованием Docker Compose.
Prevent duplicate notifications
В режиме высокой доступности каждый экземпляр Grafana запускает собственный предварительно настроенный alertmanager для обработки уведомлений об оповещениях.
Когда работают несколько экземпляров Grafana, все правила оповещения по умолчанию оцениваются на каждом экземпляре. Каждый экземпляр отправляет сработавшие оповещения в свой Alertmanager. Это приводит к дублированию обработки уведомлений на всех работающих экземплярах Grafana.
Alertmanager в режиме HA взаимодействуют друг с другом для координации доставки уведомлений. Однако такая конфигурация иногда может приводить к дублирующимся или неупорядоченным уведомлениям. По своей архитектуре HA отдаёт приоритет отправке дублирующихся уведомлений перед риском пропуска уведомлений.
Чтобы избежать дублирующихся уведомлений, вы можете настроить общий alertmanager для управления уведомлениями всех экземпляров Grafana. Дополнительную информацию см. в разделе добавление внешнего alertmanager.