 Grafana
Документация GlaberGraph
Учебные материалы
Начало работы с Grafana Alerting — маршрутизация оповещений с помощью динамических меток
Учебное руководство «Начало работы с Grafana Alerting — динамическая маршрутизация» является продолжением руководства Начало работы с Grafana Alerting — шаблонизация.
Представьте, что вы управляете веб-приложением или парком серверов, отслеживая такие критические метрики, как использование CPU, памяти и диска. Хотя наблюдение необходимо, управление оповещениями позволяет вашей команде реагировать на проблемы, не чувствуя себя перегруженной информационным шумом.
В этом учебном руководстве вы научитесь:
- Использовать политики уведомлений для динамической маршрутизации на основе значений запросов: используйте политики уведомлений для маршрутизации оповещений на основе динамически генерируемых меток так, чтобы критические оповещения достигали дежурной команды, а менее срочные уходили в общий канал мониторинга.
Перед началом работы
-
Интерактивная среда обучения
- Кроме того, вы можете попробовать этот пример в нашей интерактивной среде обучения. Это полностью настроенная среда, в которой уже установлены все зависимости.
-
Grafana OSS
- Если вы решили запустить стек Grafana локально, убедитесь, что у вас установлены следующие приложения:
- Docker Compose (входит в состав Docker for Desktop для macOS и Windows)
- Git
- Если вы решили запустить стек Grafana локально, убедитесь, что у вас установлены следующие приложения:
Настройка стека Grafana
Чтобы наблюдать данные с помощью стека Grafana, загрузите и запустите следующие файлы.
-
Клонируйте репозиторий среды учебного руководства.
git clone https://github.com/tonypowa/grafana-prometheus-alerting-demo.git -
Перейдите в каталог, в который вы клонировали репозиторий:
cd grafana-prometheus-alerting-demo -
Соберите стек Grafana:
docker compose build -
Запустите контейнеры:
docker compose up -dПри первом запуске
docker compose up -dDocker загружает все необходимые для учебного руководства ресурсы. В зависимости от скорости вашего интернет-соединения это может занять несколько минут.
Note
Если на вашей системе уже запущены Grafana, Loki или Prometheus, вы можете увидеть ошибки, потому что Docker-образ пытается использовать порты, которые уже заняты вашими локальными установками. Если это так, остановите службы, а затем снова выполните команду.
Вариант использования: мониторинг и оповещение о работоспособности системы с помощью Prometheus и Grafana
В этом варианте использования мы сосредоточимся на мониторинге использования CPU, памяти и диска системы в рамках настройки мониторинга. Этот пример основан на демонстрации Grafana Prometheus Alerting, которая собирает и визуализирует системные метрики с помощью Prometheus и Grafana.
Ваша команда отвечает за обеспечение работоспособности ваших серверов, и вы хотите использовать расширенные функции оповещения в Grafana, чтобы:
- Определять, кто должен получать уведомление об оповещении, на основе значения запроса.
- Подавлять оповещения на основе значения запроса.
Сценарий
В предоставленной демонстрационной настройке вы отслеживаете:
- Использование CPU.
- Потребление памяти.
У вас есть смесь критических оповещений (например, использование CPU выше 75%) и предупреждающих оповещений (например, использование памяти выше 60%).
Этот Python-скрипт на базе Flask имитирует службу, которая:
- Генерирует случайные значения использования CPU и памяти (от 10% до 100%) каждые 10 секунд.
- Предоставляет их как метрики Prometheus.
- Каждая метрика включает метку экземпляра по умолчанию на основе цели сбора:
instance="flask-prod:5000"instance="flask-staging:5000"
- Пользовательская метка развёртывания, добавленная явно в логику приложения (служит дополнительным примером для динамической маршрутизации производственных экземпляров):
deployment="prod-us-cs30"deployment="staging-us-cs20"
Цель
Использовать шаблоны для динамического заполнения пользовательской метки, которая соответствует политике уведомлений, и, следовательно, маршрутизировать оповещения в правильную точку контакта.
Мы будем автоматически определять среду, связанную с каждым сработавшим оповещением, путём проверки системных метрик (например, CPU, память) и извлечения ключевых слов с помощью регулярных выражений на языке шаблонов Go.
Шаг 1: создание политик уведомлений
Политики уведомлений маршрутизируют экземпляры оповещений в точки контакта через сопоставители меток. Поскольку мы знаем, какие метки возвращает наше приложение (например, job, instance, deployment), мы можем использовать их для сопоставления правил оповещения и определения соответствующей маршрутизации уведомлений.
Хотя наше приложение явно не включает метку environment, мы можем полагаться на другие метки, такие как instance или deployment, которые могут содержать ключевые слова (например, prod или staging), указывающие на среду.
-
Войдите в Grafana:
- Пользователи Grafana Cloud: войдите через Grafana Cloud.
- Пользователи OSS: перейдите на http://localhost:3000.
-
Перейдите в Alerts & IRM > Alerting > Notification Policies.
-
Добавьте дочернюю политику:
- В политике по умолчанию нажмите + New child policy.
- Label:
environment. - Operator:
=. - Value:
production. - Эта метка сопоставляет правила оповещения, где метка среды равна
prod.
-
Выберите точку контакта:
- Если у вас нет точек контакта, добавьте точку контакта.
Для быстрой проверки вы можете использовать публичный webhook с webhook.site, чтобы перехватывать и проверять уведомления об оповещениях. Если вы выберете этот метод, выберите Webhook в раскрывающемся меню в точках контакта.
-
Включите continue matching:
- Включите Continue matching subsequent sibling nodes, чтобы оценка продолжалась даже после совпадения одной или нескольких меток (например, меток environment).
-
Сохраните и повторите:
- Создайте ещё одну дочернюю политику, выполнив те же действия.
- Используйте
environment = stagingв качестве пары метка/значение. - Не стесняйтесь использовать другую точку контакта.
Теперь, когда метки определены, мы можем создать правила оповещения для метрик CPU и памяти. Эти правила оповещения будут использовать метки из собранных и сохранённых метрик в Prometheus.
Шаг 2: создание правил оповещения для мониторинга использования CPU и памяти
Выполните следующие действия, чтобы вручную создать правила оповещения и связать их с визуализацией.
Создание правила оповещения для использования CPU
- Перейдите в Alerts & IRM > Alerting > Alert rules из бокового меню Grafana.
- Нажмите + New alert rule, чтобы создать новое оповещение.
Ввод имени правила оповещения
Сделайте его коротким и описательным, так как оно будет отображаться в вашем уведомлении об оповещении. Например, cpu-usage.
Определение запроса и условия оповещения
-
Выберите источник данных Prometheus в раскрывающемся меню.
-
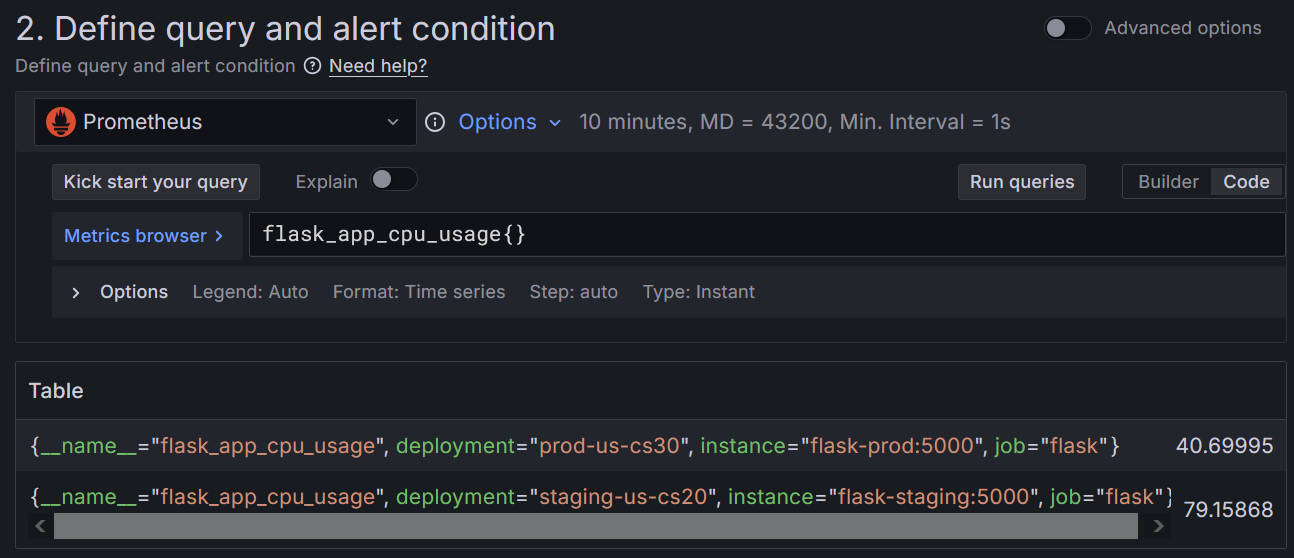
В разделе запроса введите следующий запрос:
переключитесь в режим Code, если он ещё не выбран
flask_app_cpu_usage{} -
Раздел Alert condition:
- Введите
75в качестве значения для WHEN QUERY IS ABOVE, чтобы задать порог для оповещения. - Нажмите Preview alert rule condition, чтобы выполнить запросы.

Предварительный просмотр запроса, возвращающего экземпляры оповещений в Grafana. Среди меток, возвращаемых для
flask_app_cpu_usage, меткиinstanceиdeploymentсодержат значения, включающие термин prod и staging. Позже мы создадим шаблон для обнаружения этих ключевых слов, чтобы любые сработавшие экземпляры оповещений маршрутизировались в соответствующие точки контакта (например, alerts-prod, alerts-staging). - Введите
Добавление папок и меток
В этом разделе мы добавим шаблонную метку на основе значения запроса для сопоставления с политиками уведомлений.
-
В поле Folder нажмите + New folder и введите имя. Например:
app-metrics. Эта папка будет содержать наши оповещения. -
Нажмите + Add labels.
-
В поле Key введите:
environment. -
В поле value скопируйте следующий шаблон:
{{- $env := reReplaceAll ".*([pP]rod|[sS]taging|[dD]ev).*" "${1}" $labels.instance -}}
{{- if eq $env "prod" -}}
production
{{- else if eq $env "staging" -}}
staging
{{- else -}}
development
{{- end -}}
Этот шаблон использует регулярное выражение для извлечения
prod,stagingилиdevиз метки экземпляра ($labels.instance) и сопоставляет его с более читаемой меткой (например, «production» для «prod»).
В результате, когда оповещения превышают порог, шаблон проверяет метки, такие как instance="flask-prod:5000", instance="flask-staging:5000" или пользовательские метки, такие как deployment="prod-us-cs30", и присваивает значение production, staging или development пользовательской метке environment.
Эта метка затем используется политикой уведомлений об оповещениях для маршрутизации оповещений в соответствующую команду, чтобы уведомления доставлялись эффективно и снижали ненужный шум.
Настройка поведения оценки
- Нажмите + New evaluation group. Назовите её
system-usage. - Выберите Evaluation interval (как часто будет оцениваться оповещение). Выберите
1m. - Установите pending period равным
0s(ноль секунд), чтобы правило оповещения срабатывало сразу после выполнения условия (это минимизирует время ожидания для демонстрации). - Установите Keep firing for равным
0s, чтобы оповещение прекращало срабатывать сразу после того, как условие перестало выполняться.
Настройка уведомлений
Выберите, кто должен получать уведомление при срабатывании правила оповещения.
-
Переключите кнопку Advance options.
-
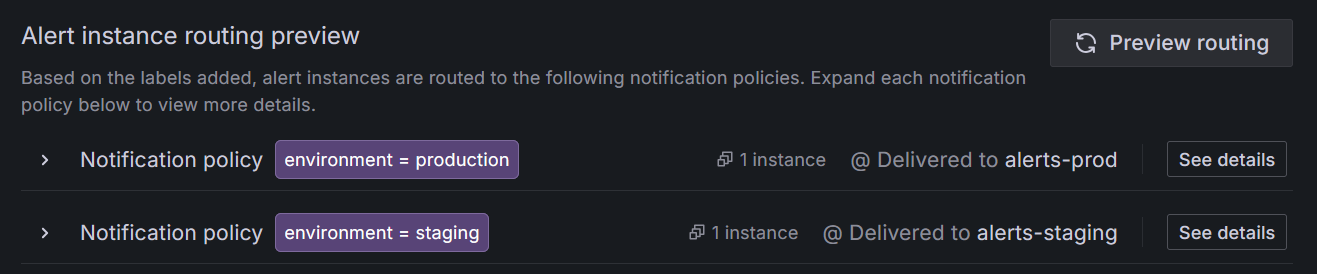
Нажмите Preview routing. В предварительном просмотре должно отображаться, какие сработавшие оповещения маршрутизируются в точки контакта на основе политик уведомлений, соответствующих метке
environment.
Политики уведомлений, сопоставленные сопоставителем метки среды. Сопоставитель метки среды должен сопоставляться с политиками уведомлений, созданными ранее. Это гарантирует, что сработавшие экземпляры оповещений маршрутизируются в соответствующие точки контакта, связанные с каждой политикой.
Шаг 3: создание второго правила оповещения для использования памяти
- Дублируйте существующее правило оповещения (More > Duplicate) или создайте новое правило оповещения для использования памяти, задав пороговое условие (например, использование памяти выше
60%). - Дайте ему имя. Например:
memory-usage. - Запрос:
flask_app_memory_usage{}. - Свяжите его с той же визуализацией, чтобы получать аннотации об использовании памяти всякий раз, когда правило оповещения срабатывает или разрешается.
Теперь, когда правила оповещения для CPU и памяти настроены, они связаны с политиками уведомлений через добавленный нами пользовательский сопоставитель меток. Значение метки динамически изменяется на основе шаблона среды, использующего $labels.instance. Это гарантирует, что значение метки будет установлено в production, staging или development в зависимости от среды.
Готово! Ваши оповещения теперь маршрутизируются динамически
На основе значений метки instance вашего запроса (которые содержат ключевые слова, такие как prod или staging) Grafana динамически присваивает значение production, staging или development пользовательской метке environment с помощью шаблона. Затем эта динамическая метка сопоставляется с сопоставителями меток в ваших политиках уведомлений, которые маршрутизируют оповещения в правильные точки контакта.
Чтобы увидеть это в действии, перейдите в Alerts & IRM > Alerting > Active notifications.
На этой странице отображаются сгруппированные оповещения, которые в настоящее время запускают уведомления. Если вы нажмёте на любую группу оповещений, чтобы просмотреть её набор меток, точку контакта и количество экземпляров оповещений. Обратите внимание, что метка environment была динамически заполнена значениями, такими как production.
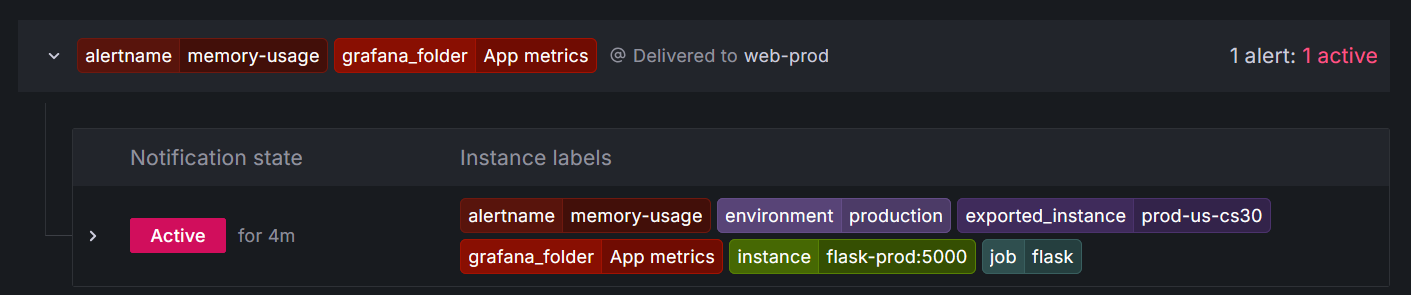
Наконец, вы должны получать уведомления в точке контакта, связанной либо с prod, либо с staging.
Не стесняйтесь экспериментировать, изменяя шаблон для сопоставления с другими метками, содержащими любые из отслеживаемых ключевых слов. Например, вы можете ссылаться на:
$labels.deploymentШаблон должен быть достаточно гибким, чтобы захватывать целевые ключевые слова (например, prod, staging), изменяя, на какую метку ссылается $labels.
Заключение
Используя политики уведомлений, вы можете маршрутизировать оповещения на основе значений запросов, направляя их в соответствующие команды.
Дополнительно в Grafana Alerting — связывание оповещений с визуализациями
Tip
В руководстве Grafana Alerting — связывание оповещений с визуализациями вы создадите оповещения с использованием данных Prometheus и свяжете их со своими графиками.
Изучите связанные темы, рассматриваемые в этом учебном руководстве:
- Поймите, как работает маршрутизация оповещений, в руководстве Начало работы с Grafana Alerting — маршрутизация оповещений.
- Узнайте, как работает шаблонизация, в руководстве Начало работы с Grafana Alerting — шаблонизация.
- Дополнительные примеры шаблонизации меток.