
Редактор запросов Elasticsearch
Grafana предоставляет редактор запросов для Elasticsearch. Запросы Elasticsearch используют формат Lucene. Дополнительные сведения о синтаксисе запросов см. в разделах Lucene query syntax и Query string syntax.
Note
При составлении запросов Lucene обязательно используйте логические операторы в верхнем регистре:
AND,ORиNOT. Версии этих операторов в нижнем регистре не поддерживаются синтаксисом запросов Lucene.
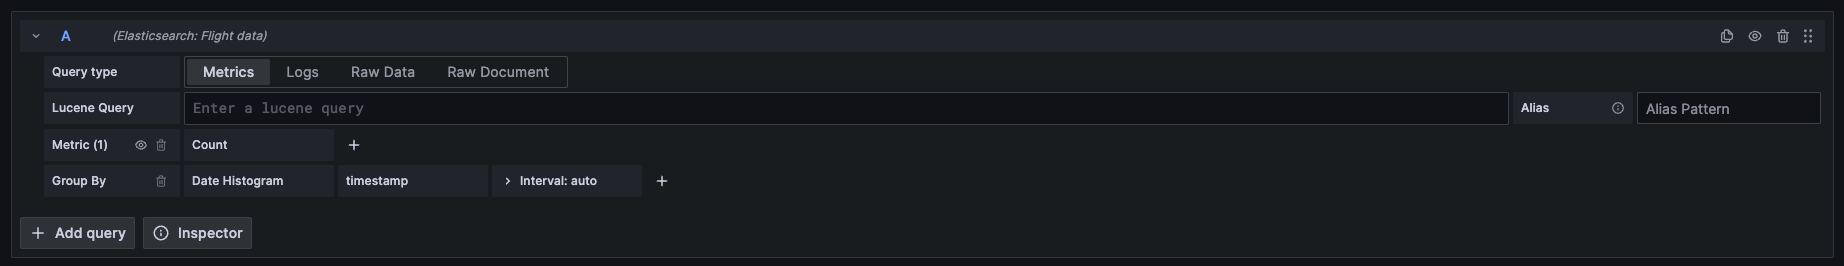
Общую документацию по запросам к источникам данных в Grafana, включая параметры и функции, общие для всех редакторов запросов, см. в разделе Query and transform data.
Типы агрегаций
Elasticsearch делит агрегации на три категории:
-
Bucket — bucket-агрегации не вычисляют метрики, они создают группы (buckets) документов на основе значений полей, диапазонов и множества других критериев. Дополнительные сведения см. в разделе Bucket aggregations. Используйте bucket-агрегации в разделе
Group byпри создании запроса метрик в конструкторе запросов. -
Metrics — метрические агрегации выполняют вычисления, такие как sum, average, min и т. д. Они могут быть одно- или многозначными. Дополнительные сведения см. в разделе Metrics aggregations. Используйте метрические агрегации в типе запроса метрик в конструкторе запросов.
-
Pipeline — pipeline-агрегации работают с результатом других агрегаций, а не с документами или полями. Дополнительные сведения см. в разделе Pipeline aggregations.
Выбор типа запроса
С помощью конструктора запросов Elasticsearch можно создавать два типа запросов. Каждый тип подробно описан ниже.
Используйте переключатель Preserve query, чтобы сохранять запрос Lucene при переключении между режимами Metrics, Logs, Raw Data и Raw Document. Когда переключатель выключен (по умолчанию для новых запросов), переключение типа запроса очищает запрос Lucene. Grafana запоминает последний выбор Preserve query в браузере для новых запросов.
Тип запроса Metrics
Запросы метрик агрегируют данные и выполняют вычисления, такие как count, min, max и другие. Нажмите на поле метрики, чтобы просмотреть параметры в раскрывающемся меню. По умолчанию используется count.
-
Alias — псевдонимы применяются только к запросам временных рядов, где последняя группа —
date histogram. Для всех других типов запросов этот параметр игнорируется. -
Metric — метрические агрегации включают:
- count — см. Value count aggregation
- average — см. Avg aggregation
- sum — см. Sum aggregation
- max — см. Max aggregation
- min — см. Min aggregation
- extended stats — см. Extended stats aggregation
- percentiles — см. Percentiles aggregation
- unique count — см. Cardinality aggregation
- top metrics — см. Top metrics aggregation
- rate — см. Rate aggregation
-
Sibling bucket aggregations — эти метрики вычисляют внешнюю статистику по внутренней статистике каждой группы в пределах каждой временной группы. Например, Sum Bucket с внутренней Max даёт сумму максимумов по всем хостам. Доступны следующие параметры:
- Sum Bucket — см. Sum bucket aggregation
- Max Bucket — см. Max bucket aggregation
- Min Bucket — см. Min bucket aggregation
- Average Bucket — см. Avg bucket aggregation
-
Pipeline aggregations — pipeline-агрегации работают с результатом других агрегаций, а не с документами. Доступны следующие pipeline-агрегации:
- moving function — вычисляет значение на основе скользящего окна агрегированных значений. См. Moving function aggregation.
- derivative — вычисляет производную метрики. См. Derivative aggregation.
- cumulative sum — вычисляет накопительную сумму метрики. См. Cumulative sum aggregation.
- serial difference — вычисляет разницу между значениями во временном ряду. См. Serial differencing aggregation.
- bucket script — выполняет скрипт над значениями метрик из других агрегаций. См. Bucket script aggregation.
В редакторе запросов Elasticsearch можно выбирать несколько метрик и группировать по нескольким терминам или фильтрам.
Используйте знак + справа, чтобы добавить несколько метрик в запрос. Нажмите на значок глаза рядом с Metric, чтобы скрыть метрики, и на значок мусорной корзины, чтобы удалить метрики.
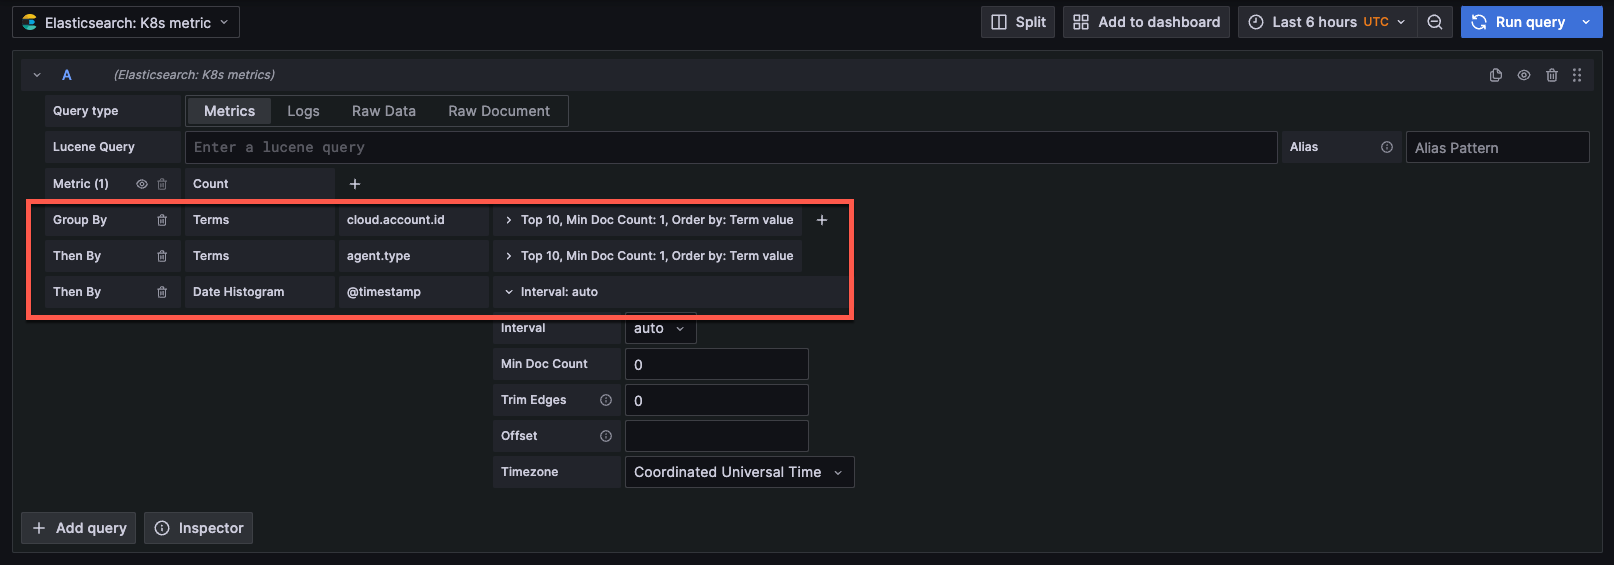
- Параметры Group by — создавайте несколько вариантов группировки при построении запроса Elasticsearch. По умолчанию используется date histogram. В раскрывающемся меню доступны следующие параметры:
- terms — см. Terms aggregation.
- filter — см. Filter aggregation.
geo hash grid— см.geohash_gridaggregation.- date histogram — для запросов временных рядов. См. Date histogram aggregation.
- histogram — отображает частотные распределения. См. Histogram aggregation.
- nested (экспериментально) — см. Nested aggregation.
Для каждого параметра Group by доступен свой набор опций, позволяющих дополнительно сузить запрос.
Следующие параметры относятся к конкретному варианту bucket-агрегации date histogram.
- Time field — поле, используемое для запросов по времени. Значение по умолчанию можно задать при настройке источника данных в параметре Time field name в разделе
Elasticsearch details. По умолчанию —
@timestamp. - Interval — временной интервал группировки данных. Выберите значение в раскрывающемся меню или введите собственный интервал, например
30d(30 дней). По умолчанию —Auto. - Min doc count — минимальное количество документов, необходимое для включения группы. По умолчанию —
0. - Trim edges — удаляет неполные группы на границах временного диапазона. По умолчанию —
0. - Offset — сдвигает начало каждой группы на указанную длительность. Используйте положительные (
+) или отрицательные (-) значения. Примеры:1h,5s,1d. - Timezone — часовой пояс для вычислений дат. По умолчанию —
Coordinated Universal Time.
Настройте следующие параметры для варианта bucket-агрегации terms:
- Order — задаёт порядок данных. Возможные значения:
topилиbottom. - Size — ограничивает количество документов или размер набора данных. Можно задать собственное число или
no limit. - Min doc count — минимальный объём данных, включаемый в запрос. По умолчанию —
0. - Order by — упорядочивает термы по
term value,doc countилиcount. - Missing — определяет, как следует обрабатывать документы с отсутствующим значением. По умолчанию отсутствующие значения игнорируются, но их можно обрабатывать так, как если бы у них было значение. Дополнительные сведения см. в разделе Missing value документации Elasticsearch.
Настройте следующие параметры для варианта bucket-агрегации filters:
- Query — укажите запрос для создания группы документов (данных). Примеры:
hostname:"hostname1",product:"widget5". Используйте подстановочный знак * для сопоставления любого количества символов. - Label — добавьте метку или имя для группы.
Настройте следующие параметры для варианта bucket-агрегации geo hash grid:
- Precision — задаёт количество символов в
geo hash.
Настройте следующие параметры для варианта bucket-агрегации histogram:
- Interval — числовой интервал для группировки значений по группам.
- Min doc count — минимальное количество документов, необходимое для включения группы. По умолчанию —
0.
Параметр группировки nested в настоящее время является экспериментальным: можно выбрать поле и затем настройки, специфичные для этого поля.
Нажмите знак +, чтобы добавить несколько параметров группировки. Данные группируются по порядку (сначала по первому, затем по второму).
Тип запроса Logs
Запросы логов анализируют данные логов Elasticsearch. Можно настроить следующие параметры:
- Logs Options/Limit — ограничивает количество логов для анализа. По умолчанию —
500.
Параметры запроса
Откройте раздел Options в редакторе запросов, чтобы настроить параметры уровня запроса:
- Limit или Size — для запросов Logs и Raw Data задаёт максимальное количество возвращаемых документов. По умолчанию —
500. - Include runtime fields — если включено, в ответ включаются runtime-поля, определённые в маппинге индекса. Этот параметр доступен в режиме Builder.
Редактор необработанных запросов
Редактор необработанных запросов позволяет писать запросы Elasticsearch с использованием нативного Elasticsearch Query DSL.
Переключение между режимами Builder и Code
Чтобы открыть редактор необработанных запросов, нажмите переключатель Code в правом верхнем углу редактора запросов. Можно переключаться между режимами Builder и Code:
- Builder — визуальный конструктор запросов с раскрывающимися меню и формами
- Code — редактор JSON для написания необработанных запросов Elasticsearch DSL
Написание необработанных запросов DSL
В режиме Code можно писать полный Elasticsearch Query DSL в формате JSON. Редактор предоставляет:
- Подсветку синтаксиса для JSON
- Автоформатирование — нажмите кнопку Format или сочетание клавиш
Shift+Alt+F, чтобы отформатировать запрос - Горячие клавиши — нажмите
Ctrl+Enter(илиCmd+Enterна Mac), чтобы выполнить запрос - Проверку в реальном времени — неверный JSON подсвечивается с сообщениями об ошибках
Обработка временных диапазонов
Если вы хотите фильтровать по временному диапазону на дашборде, необходимо использовать макросы $__from и $__to в необработанном DSL.
Пример запроса, применяющего временной диапазон дашборда с использованием поля @timestamp:
{
  "query": {
    "bool": {
      "must": [
        {
          "range": {
            "@timestamp": {
              "gte": "$__from",
              "lte": "$__to",
              "format": "epoch_millis"
            }
          }
        }
      ]
    }
  }
}
Поддерживаемые типы запросов
Редактор необработанных запросов поддерживает все типы запросов:
- Запросы метрик используются для запроса данных временных рядов с агрегациями. Парсер запросов автоматически извлекает bucket- и метрические агрегации из вашего DSL и использует их для обработки ответа.
- Запросы логов используются для запроса данных логов.
Редактор запросов ES|QL
Редактор запросов ES|QL позволяет выполнять запросы к Elasticsearch с использованием ES|QL (Elasticsearch Query Language) — конвейерного языка запросов. В отличие от запросов Lucene, которые полагаются на настройку агрегаций в интерфейсе конструктора, ES|QL позволяет выразить фильтрацию, агрегацию и преобразование в одной строке запроса.
Введение в синтаксис и концепции ES|QL см. в разделе Get started with ES|QL queries документации Elasticsearch.
Когда запрос ES|QL не содержит фильтра по времени, Grafana автоматически добавляет фильтр временного диапазона на основе дашборда или выбора времени в Explore.
Выбор индекса
То, как редактор обрабатывает выбор индекса, зависит от конфигурации источника данных:
- Имя индекса не настроено: вы указываете, по какому индексу выполнять запрос, с помощью команды
FROMнепосредственно в запросе ES|QL. Это позволяет запрашивать любой индекс без создания отдельного источника данных для каждого. - Имя индекса настроено: редактор автоматически вставляет
FROM $__index, когда поле ES|QL получает фокус. При необходимости это можно переопределить и запросить другой индекс.
Возможности редактора
Редактор кода ES|QL предоставляет:
- Подсказки кода — автодополнение команд и функций ES|QL
- Подсветку ошибок — синтаксические ошибки подсвечиваются в редакторе, а сообщения об ошибках от Elasticsearch отображаются напрямую
- Подсветку синтаксиса — ключевые слова, операторы и значения ES|QL выделяются цветом для удобства чтения
Примеры запросов
Следующие примеры демонстрируют распространённые шаблоны запросов ES|QL.
Базовая агрегация
Подсчёт документов с группировкой по полю:
FROM logs-*
| STATS count = COUNT(*) BY host.name
| SORT count DESC
| LIMIT 10
Фильтрация и агрегация по времени
Фильтрация по значению поля и вычисление среднего за временные интервалы:
FROM metrics-*
| WHERE service.name == "api-gateway"
| STATS avg_duration = AVG(transaction.duration.us) BY @timestamp = BUCKET(@timestamp, 1 minute)
| SORT @timestamp
Поиск сообщений в логах
Поиск определённых шаблонов в данных логов:
FROM logs-*
| WHERE message LIKE "*error*" AND log.level == "ERROR"
| KEEP @timestamp, message, host.name, log.level
| SORT @timestamp DESC
| LIMIT 100
Запросы метрик PromQL
Когда вы выбираете тип запроса Metrics, ES|QL также принимает исходную команду PROMQL. Grafana обрабатывает ответ как кадры временных рядов — так же, как для запросов STATS в ES|QL. PROMQL должна быть первой командой в запросе (ведущие комментарии допускаются):
PROMQL index=metrics-* step=1m avg(metrics.system.cpu.logical.count)Подробнее об ES|QL
Дополнительные сведения о синтаксисе, командах и функциях ES|QL см. в следующей документации Elasticsearch:
- ES|QL reference — обзор языка запросов ES|QL
- ES|QL commands — исходные и обрабатывающие команды (
FROM,WHERE,STATS,EVAL,KEEP,SORT,LIMITи другие) - ES|QL functions and operators — агрегатные, математические, строковые, датовые и другие функции
- ES|QL syntax — идентификаторы, литералы, операторы и специальные символы
Использование шаблонных переменных
Вы также можете дополнять запросы с помощью шаблонных переменных.
Запросы terms по умолчанию ограничены 500 результатами.
Чтобы задать собственное ограничение, установите свойство size в запросе.