
Handle connectivity errors in alerts
Проблемы со связностью — распространённая причина вводящих в заблуждение оповещений или незамеченных сбоев.
Причин этих ошибок может быть несколько. Возможно, ваша цель стала недоступна или Prometheus не смог её собрать. Или, возможно, ваш запрос оповещения дал сбой из-за тайм-аута цели или падения сети. Эти ситуации могут выглядеть похоже, но требуют разных подходов в вашей конфигурации оповещений.
Это руководство описывает, как обнаруживать и обрабатывать такие типы сбоев, независимо от того, пишете ли вы правила оповещения в Prometheus, используете Grafana Alerting или комбинируете оба. Оно охватывает как мониторинг доступности, так и сбои запросов оповещений, и описывает стратегии повышения надёжности ваших оповещений.
Understand connectivity issues in alerts
Как правило, проблемы со связностью попадают в несколько распространённых сценариев:
- Серверы или контейнеры упали или были выключены.
- Перегрузка сервиса или тайм-аут.
- Неправильно настроенная аутентификация или некорректные разрешения.
- Сетевые проблемы, такие как проблемы с DNS или сбои у провайдера.
Когда мы говорим об ошибках связности в оповещениях, мы обычно имеем в виду один из двух случаев использования:
-
Ваша цель недоступна или недостижима.
Сервис упал, хост был недоступен, или проблема с брандмауэром или DNS заблокировала соединение. Это проблемы доступности. -
Ваш запрос оповещения дал сбой.
Оповещение не смогло выполнить свой запрос — возможно, из-за тайм-аута источника данных или недопустимого запроса. Это ошибки выполнения.
Полезно разделять эти случаи на раннем этапе, поскольку они ведут себя по-разному и требуют разных стратегий.
Имейте в виду, что большинство правил оповещения не обращаются к цели напрямую. Они запрашивают метрики из системы мониторинга, такой как Prometheus, которая собирает данные из вашей фактической инфраструктуры или приложения. Это даёт нам две типичные конфигурации оповещений, в которых могут проявляться проблемы со связностью:
-
Правило оповещения → Цель
Например, правило оповещения, запрашивающее внешний источник данных, такой как база данных. -
Правило оповещения → Prometheus ← Цель
Более распространено в стеках observability. Например, Prometheus собирает данные с узла или контейнера, а правило оповещения позже запрашивает метрики.Во второй конфигурации вы можете столкнуться с проблемами связности с любой стороны. Если Prometheus не может собрать данные с цели, ваше правило оповещения может не сработать, даже если что-то, вероятно, не так.
Detect target availability with the Prometheus up metric
Prometheus регулярно собирает метрики со своих целей с периодом scrape_interval. Интервал сбора по умолчанию — 60 секунд, что обычно считается общепринятой практикой.
Prometheus предоставляет встроенную метрику up для каждой цели сбора — простой способ указать, успешен ли сбор:
-
up == 1: Ваша цель достижима; Prometheus собрал метрики цели, как ожидалось. -
up == 0: Prometheus не смог достичь вашей цели — что указывает на возможный простой или сетевые ошибки.
Типичное выражение PromQL для правила оповещения, которое обнаруживает, когда цель становится недостижимой:
up == 0
Но это правило оповещения может приводить к шумным оповещениям, так как одна единственная ошибка сбора вызовет срабатывание. Чтобы уменьшить шум, вам следует добавить задержку:
up == 0 for: 5m
Опция for в Prometheus (или
период pending в Grafana) задерживает оповещение до тех пор, пока условие не будет истинным в течение всего указанного времени.
В этом примере ожидание 5 минут означает, что единичная ошибка сбора не приведёт к срабатыванию оповещения. Поскольку Prometheus по умолчанию собирает метрики каждую минуту, оповещение срабатывает только после пяти последовательных сбоев.
Однако у такого оповещения на основе up есть несколько потенциальных недостатков:
- Сбои могут ускользнуть между интервалами сбора: Сбой, который начинается и заканчивается между двумя оценками, остаётся незамеченным. Вы могли бы сократить длительность
for, но это может привести к ложным срабатываниям из-за ошибок сбора. - Промежуточные восстановления сбрасывают таймер
for: Один успешный сбор сбрасывает таймер оповещения, что маскирует промежуточные сбои.
Кратковременные перерывы связности распространены в реальных средах, поэтому ожидайте некоторую нестабильность в оповещениях на основе up. Например:
Чем длиннее период, тем более вероятно, что это произойдёт.
Одно единственное восстановление сбрасывает оповещение, поэтому up == 0 for: 5m иногда может быть ненадёжным. Даже если цель недоступна большую часть времени, оповещение не срабатывает, оставляя вас в неведении о возможной устойчивой проблеме.
Use avg_over_time to smooth signal
Один из способов обойти эти проблемы — сгладить сигнал, усреднив метрику up за аналогичный или более длительный период:
avg_over_time(up[10m]) < 0.8
Это правило оповещения срабатывает, когда цель недостижима более 20 % последних 10 минут, вместо поиска последовательных сбоев сбора. При интервале сбора в одну минуту теперь оповещение вызывают три или более неудачных сбора за последние 10 минут.
Поскольку этот запрос использует порог и временное окно для управления точностью, теперь вы можете снизить длительность for (или
период pending в Grafana) до чего-то более короткого — 0m или 1m — чтобы оповещение срабатывало быстрее.
Такой подход даёт вам больше гибкости в обнаружении реальных сбоев или сетевых проблем. Как всегда, настраивайте порог и период исходя из вашей терпимости к шуму и того, насколько критична цель.
Use synthetic checks to monitor external availability
Prometheus часто работает внутри той же сети, что и цель, которую он отслеживает. Это означает, что Prometheus может быть способен достичь цели, но это не гарантирует, что она достижима для пользователей извне.
Брандмауэры, неправильные конфигурации DNS или другие сетевые проблемы могут блокировать публичный трафик, в то время как сбор up в Prometheus успешен.
Здесь помогает синтетический мониторинг. Такие инструменты, как Blackbox Exporter, позволяют непрерывно проверять, доступен ли сервис и достижим ли он извне вашей сети — а не только изнутри.
Blackbox Exporter предоставляет результаты этих проверок как метрики, которые Prometheus может собирать, как любую другую цель. Например, метрика probe_success сообщает, смог ли пробник достичь сервиса. Конфигурация выглядит так:
Правила оповещения → Prometheus ← Blackbox Exporter (внешний пробник) → Цель
Чтобы обнаруживать, когда сервис недостижим извне, вы можете определить оповещение с использованием метрики probe_success:
probe_success == 0 for: 5m
Это оповещение срабатывает, когда пробник терпит неудачу непрерывно в течение 5 минут — указывая на то, что сервис недостижим извне.
Затем вы можете комбинировать внутренние и внешние проверки, чтобы обнаружение ошибок связности было более надёжным. Это оповещение ловит случаи, когда внутренний сбор даёт сбой или сервис недостижим извне.
up == 0 or probe_success == 0
Как и с метрикой up, вы можете захотеть сгладить это с помощью avg_over_time() для более надёжного обнаружения. Сглаженная версия может выглядеть так:
avg_over_time(up[10m]) < 0.8 or avg_over_time(probe_success[10m]) < 0.8
Это оповещение срабатывает, когда Prometheus не смог успешно собрать данные с цели более 20 % последних 10 минут, или когда внешние пробники терпят неудачу более 20 % времени. Эту технику сглаживания можно применять к любому бинарному сигналу доступности.
Manage offline hosts
Во многих конфигурациях Prometheus собирает данные с нескольких хостов под одной целью, например с парка серверов или контейнеров с общей меткой job. Обычно один хост становится недоступным, в то время как остальные продолжают штатно сообщать метрики.
Если ваше оповещение проверяет только общую метрику up, не разбивая её по меткам (таким как instance, host или pod), вы можете пропустить момент, когда хост перестаёт сообщать данные. Например, оповещение, которое смотрит только на агрегированный статус всех экземпляров, вероятно, не сможет поймать, когда отдельные экземпляры пропадают.
В данном контексте это не ошибка связности — дело не в том, что оповещение или Prometheus не могут ничего достичь, а в том, что одна или несколько конкретных целей замолчали. Такие проблемы не ловятся оповещениями вида up == 0.
В этих случаях см. дополняющее руководство по обработке отсутствующих данных — оно охватывает распространённые сценарии, когда запросы оповещений вообще не возвращают данных или когда лишь некоторые цели перестают сообщать данные. Это не полные сбои доступности и не ошибки выполнения, но они всё равно могут приводить к слепым зонам в обнаружении оповещений.
Handle query errors in Grafana Alerting
Не все проблемы со связностью возникают из-за недоступности целей. Иногда правило оповещения даёт сбой при запросе к своей цели. Это не проблемы доступности — это ошибки выполнения запросов: возможно, источник данных дал тайм-аут, сеть упала или запрос был недопустимым.
Эти ошибки приводят к сломанным оповещениям. Но они возникают в другой части стека: между правилом оповещения и источником данных, а не между источником данных (например, Prometheus) и его целью.
Это различие важно. Проблемы доступности обычно обрабатываются с помощью метрик, таких как up или probe_success, но ошибки выполнения требуют другой конфигурации.
Grafana Alerting имеет встроенную обработку ошибок выполнения, независимо от источника данных. Это включает Prometheus и другие, такие как Graphite, InfluxDB, PostgreSQL и т. д. По умолчанию Grafana Alerting автоматически обрабатывает ошибки запросов, чтобы вы не пропустили критические сбои. Когда правило оповещения не может выполниться, Grafana вызывает специальное оповещение DatasourceError.
Вы можете настроить это поведение в зависимости от того, насколько критично оповещение, и от того, есть ли у вас уже другие оповещения, обнаруживающие проблему. В разделе Configure no data and error handling нажмите Alert state if execution error or timeout и выберите нужный вариант для оповещения:
-
Error (по умолчанию): Вызывает отдельное оповещение
DatasourceError. Это значение по умолчанию гарантирует, что правила оповещения всегда сообщают об ошибках запросов, но может создавать шум. -
Alerting: Трактует ошибку так, как если бы условие оповещения срабатывало. Grafana переводит все существующие экземпляры для этого правила в состояние
Alerting. -
Normal: Игнорирует ошибку запроса и переводит все экземпляры оповещений в состояние
Normal. Это полезно, если ошибка не критична или если у вас уже есть другие оповещения, обнаруживающие проблемы со связностью. -
Keep Last State: Сохраняет предыдущее состояние до тех пор, пока запрос снова не будет успешен. Подходит для нестабильных сред, чтобы избежать дребезга оповещений.
![A screenshot of the `Configure error handling` option in Grafana Alerting.]()
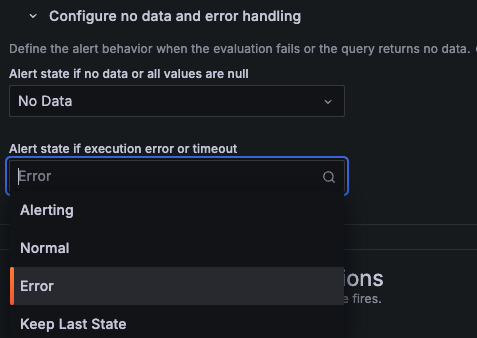
Это применимо даже когда правила оповещения запрашивают сам Prometheus — не только внешние источники данных.
Design alerts for connectivity errors
На практике начните с решения, хотите ли вы создавать явные правила оповещения — например, с использованием up или probe_success — чтобы обнаруживать, когда цель недоступна или имеет проблемы со связностью.
Затем для каждого правила оповещения выберите поведение обработки ошибок исходя из того, есть ли у вас уже выделенные оповещения о связности, стабильности цели и того, насколько критично оповещение. Расставляйте приоритеты оповещений на основе серьёзности симптомов, а не только инфраструктурных сигналов, которые могут не влиять на пользователей.
Reduce redundant error notifications
Одна ошибка источника данных может привести к одновременному срабатыванию нескольких оповещений, иногда заваливая вас множеством оповещений и создавая слишком много шума.
Как описано ранее, вы можете управлять поведением обработки ошибок для оповещений Grafana. Вариант Keep Last State или Normal предотвращает срабатывание оповещений и помогает избежать избыточных оповещений, особенно для сервисов, уже охваченных оповещениями up или probe_success.
При использовании поведения по умолчанию одна ошибка связности, вероятно, вызовет несколько оповещений DatasourceError.
Рассмотрите возможность не обращаться с этими оповещениями так же, как с исходными оповещениями, и реализуйте выделенные стратегии для их уведомлений:
-
Уменьшите дублирующиеся уведомления, группируя оповещения
DatasourceError. Используйте меткуdatasource_uidдля группировки ошибок из одного источника данных. -
Маршрутизируйте оповещения
DatasourceErrorотдельно, отправляя их в разные команды или каналы в зависимости от их влияния и срочности.
Подробности о том, как настроить группировку и маршрутизацию, см. в документации по
обработке уведомлений и
No Data и Error оповещениям.
Conclusion
Проблемы со связностью — одна из распространённых причин шумных или вводящих в заблуждение оповещений. Это руководство охватило два различных типа:
-
Проблемы доступности, когда сама цель недоступна или недостижима (например, из-за сбоя или сетевого отказа).
-
Ошибки выполнения запросов, когда правило оповещения не может достичь своего источника данных (например, из-за тайм-аутов, недопустимых запросов или сбоев источника данных).
Эти проблемы возникают в разных частях вашего стека и требуют собственных техник. Prometheus и Grafana позволяют обнаруживать их, и комбинирование различных техник может сделать ваши оповещения более устойчивыми.
С Prometheus избегайте опоры исключительно на up == 0. Сглаживайте запросы, чтобы учесть промежуточные сбои, и используйте синтетический мониторинг для обнаружения проблем достижимости извне вашей сети.
В Grafana Alerting настраивайте обработку ошибок явно. Не все оповещения равны или имеют одинаковую срочность. Настраивайте поведение обработки ошибок в зависимости от надёжности и серьёзности оповещений и от того, есть ли у вас уже оповещения, посвящённые проблемам связности.
И не забывайте о третьем случае: отсутствующие данные. Если из парка хостов тихо исчезает только один хост, вы можете не получить оповещения. Если вы имеете дело с отдельными экземплярами, которые перестали сообщать данные, см. Руководство по обработке отсутствующих данных, чтобы продолжить изучение этой темы.