
Что такое Prometheus?
Observability (наблюдаемость) сосредоточена на понимании внутреннего состояния ваших систем по данным, которые они создают, что помогает определить, здорова ли ваша инфраструктура. Prometheus — ключевая технология для мониторинга и наблюдаемости систем, но термин «Prometheus» может сбивать с толку, так как используется в разных контекстах. Понимание основ Prometheus, того, почему это ценно для наблюдаемости систем, и того, как пользователи применяют его на практике, поможет вам и лучше разобраться в нём, и эффективнее использовать Grafana.
Prometheus появился в 2012 году в SoundCloud, потому что существующие технологии не отвечали их потребностям в наблюдаемости. Prometheus предлагает и надёжную модель данных, и язык запросов. Кроме того, Prometheus прост и масштабируем. В 2018 году Prometheus выпустился из инкубации Cloud Native Computing Foundation (CNCF), и сегодня у него процветающее сообщество.
Prometheus как данные
Следующая панель на дашборде Grafana показывает, насколько интенсивно используется пропускная способность диска на ноутбуке Mac. Зелёная линия соответствует чтению с диска (reads), а жёлтая — записи (writes).
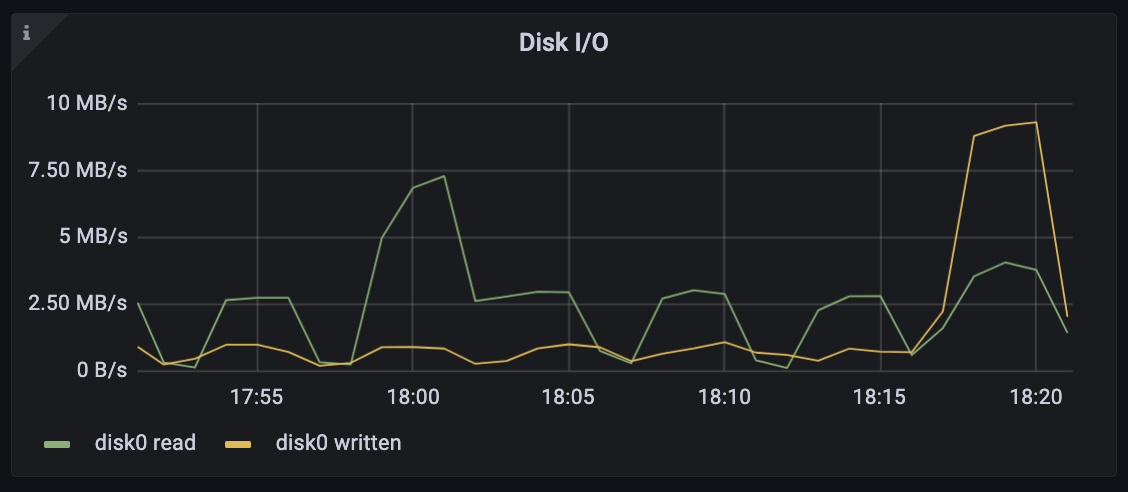
Такие данные образуют временные ряды. По оси X отложен момент времени, по оси Y — число или измерение, например 5 мегабайт в секунду. Такой тип данных временных рядов встречается повсюду в мониторинге систем, а также, например, в сезонных графиках температуры и ценах на акции. Эти данные — просто некоторое измерение (например, цена акции компании или дисковая I/O) через последовательность моментов времени.
Prometheus — технология, которая собирает и хранит данные временных рядов. Временные ряды лежат в основе Prometheus; его модель данных организована в:
- метрики, состоящие из timestamp и sample — числового значения, например сколько байтов было прочитано с диска или цена акции
- набор меток, называемых измерениями, например
jobиdevice
Вы можете хранить данные временных рядов в любой реляционной базе данных, однако такие системы не предназначены для хранения и запроса больших объёмов данных временных рядов. Prometheus и подобное программное обеспечение предоставляют инструменты для сжатия и оптимизации данных временных рядов.
Простой дашборд с использованием PromQL
На следующем изображении дашборда Grafana показан график Disk I/O с необработанными данными из Prometheus, полученными с ноутбука.
Поле Metrics browser содержит следующий запрос:
node_disk_written_bytes_total{job="integrations/macos-node", device!=""}
В этом примере по оси Y показано общее количество записанных байтов, а по оси X — даты и время. По мере работы ноутбука число записанных байтов растёт со временем. Ниже Metrics browser находится счётчик, который подсчитывает количество записанных байтов со временем.
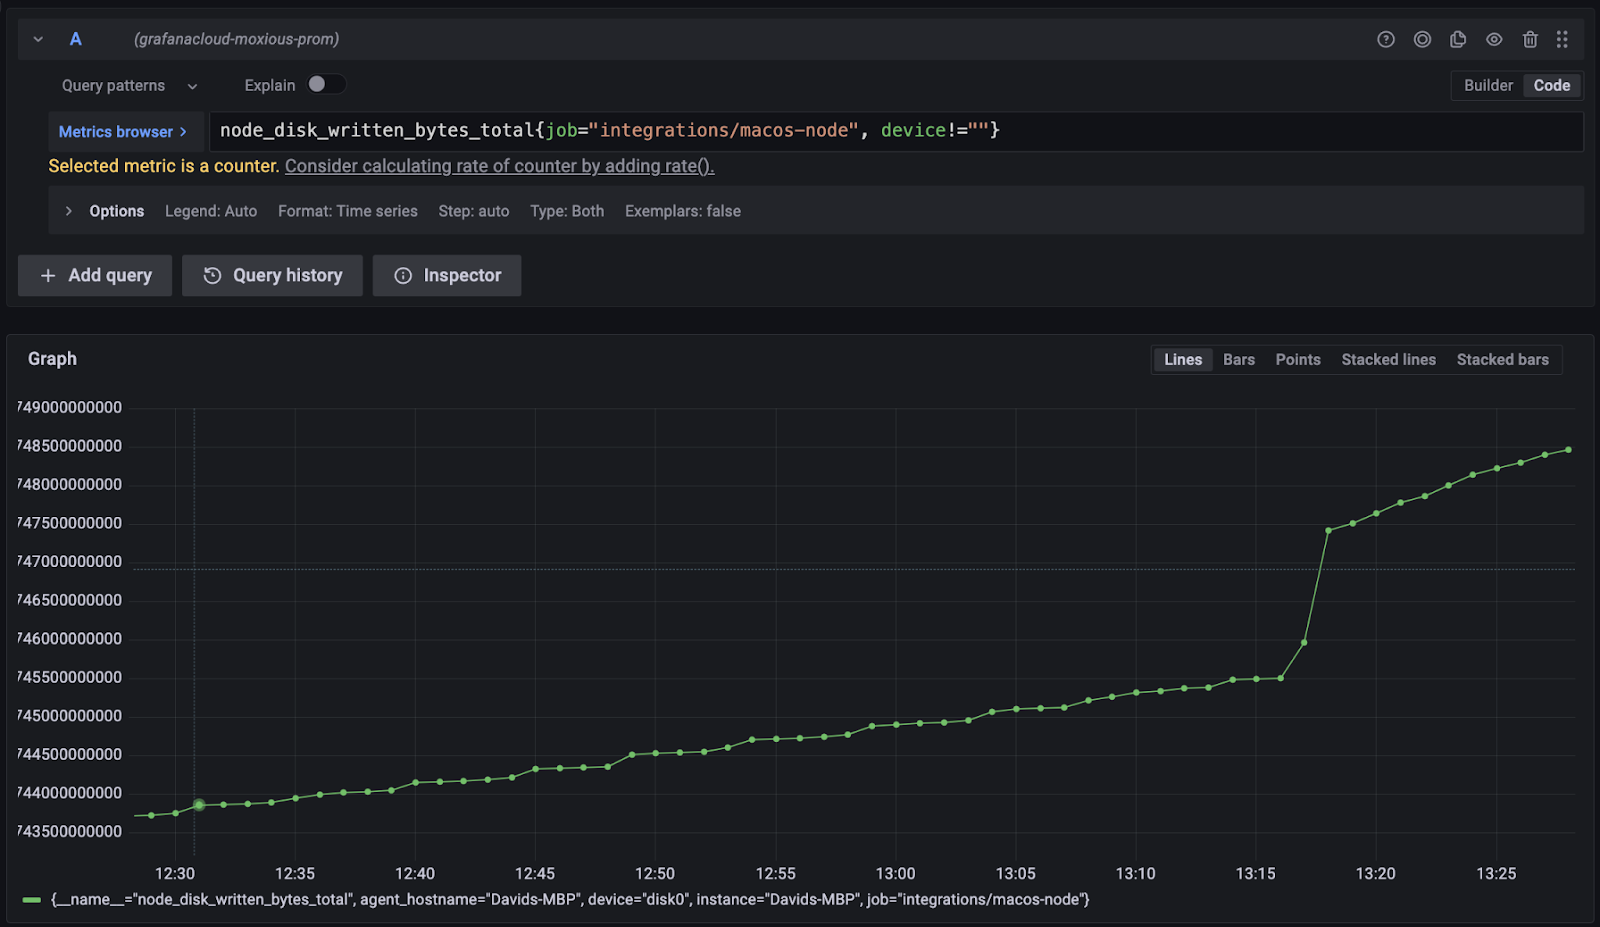
Запрос — простой пример PromQL, языка запросов Prometheus. Запрос определяет интересующую метрику (node_disk_written_bytes_total) и предоставляет две метки (job и device). Селектор метки job="integrations/macos-node" фильтрует метрики. Он и сужает область метрик до тех, что приходят от задания интеграции MacOS, и задаёт, что метка «device» не может быть пустой. Результат этого запроса — необработанный поток чисел, который отображает график.
Хотя это представление даёт некоторое понимание производительности системы, оно не рассказывает всей истории. Более ясная картина производительности системы требует понимания скорости изменения, которое показывает, как быстро меняются записываемые данные. Чтобы правильно отслеживать производительность диска, нужно также видеть всплески активности, которые показывают, когда система находится под нагрузкой и есть ли риск для производительности диска. PromQL включает функцию rate(), которая показывает среднюю скорость прироста в секунду за интервалы по 5m (5 минут). Это представление даёт гораздо более ясную картину того, что происходит с системой.
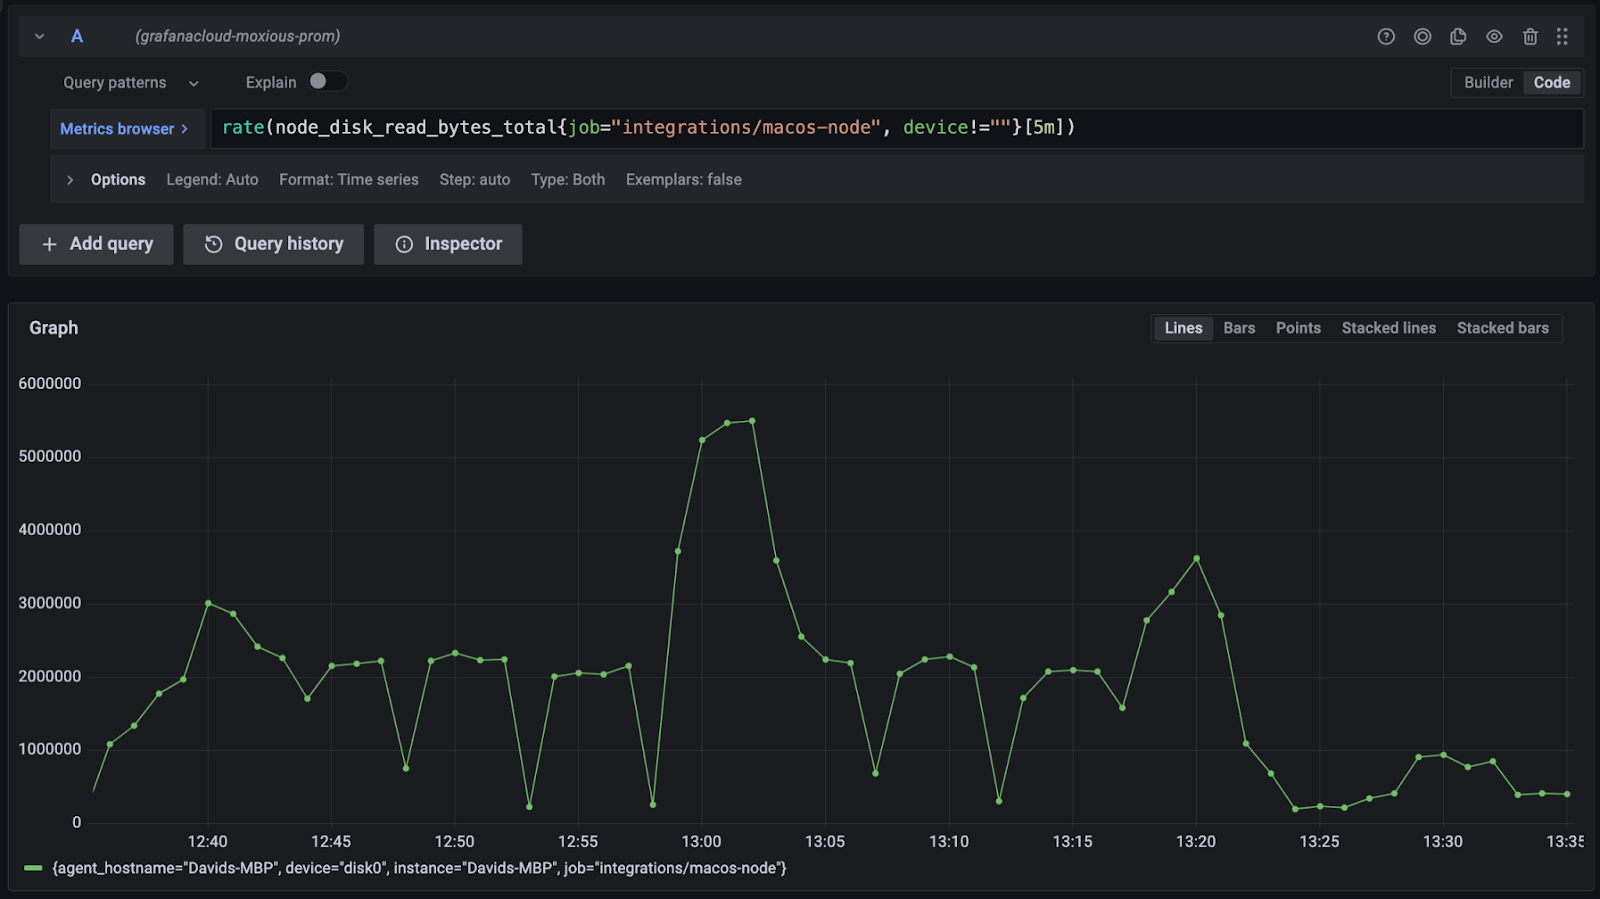
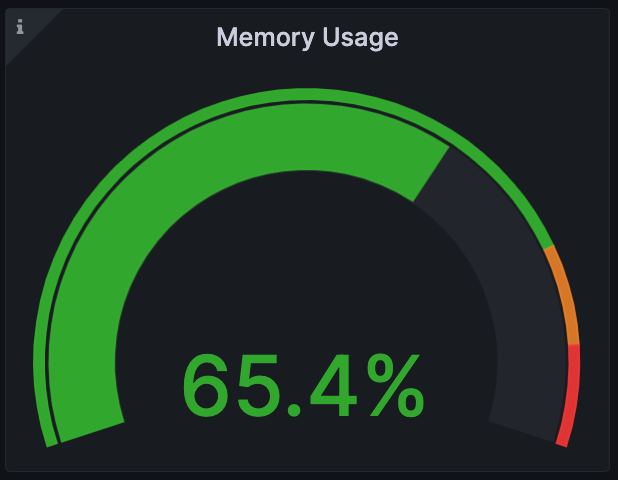
Метрика-счётчик — лишь один из типов метрик; это число (например, общее количество записанных байтов), которое только увеличивается. Prometheus поддерживает и другие, например тип метрики gauge, который может увеличиваться или уменьшаться.
Следующая визуализация gauge отображает общее использование оперативной памяти на компьютере.
Третий тип метрик называется histogram: он подсчитывает наблюдения и организует их в настраиваемые группы. Следующий пример отображает числа с плавающей точкой, сгруппированные в диапазоны, показывающие, как часто встречается каждый из них.
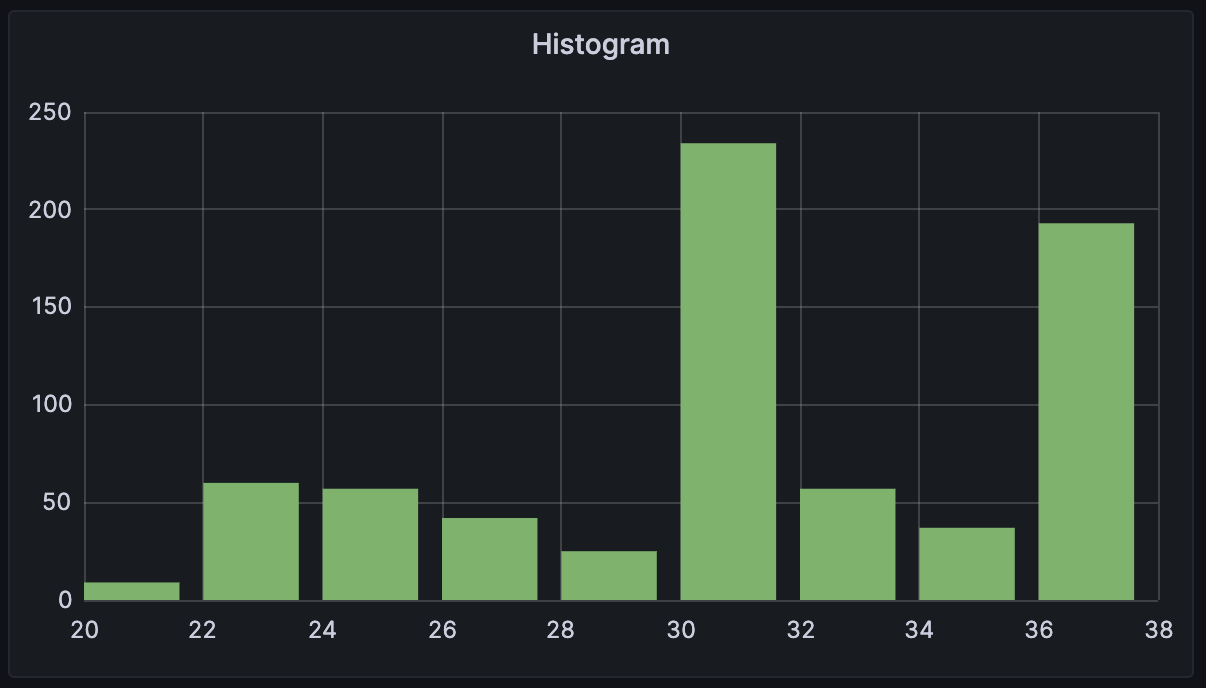
Эти базовые понятия временных рядов, метрик, меток и функций агрегации лежат в основе Grafana и наблюдаемости.
Почему это ценно
Программное обеспечение и системы — непростое дело. Иногда что-то идёт не так. Наблюдаемость помогает вам понять состояние системы, чтобы проблемы можно было быстро выявить и проактивно устранить. А когда проблемы всё же возникают, вы можете получать о них оповещения, чтобы диагностировать и решить их в рамках ваших целей уровня обслуживания (SLO).
Три столпа наблюдаемости — это метрики, логи и трейсы. Prometheus поддерживает столп метрик. Когда программное обеспечение на компьютере работает медленно, наблюдаемость помогает определить, насыщен ли процессор, закончилась ли память в системе или диск пишет на максимальной скорости, чтобы вы могли проактивно отреагировать.
Prometheus как программное обеспечение
Prometheus — не просто формат данных; это также открытый набор инструментов для мониторинга и оповещения систем. Потому что Prometheus — это программное обеспечение, а не только данные.
Prometheus может собирать (scrape) данные метрик из программного обеспечения и инфраструктуры и хранить их. Сбор означает, что программное обеспечение Prometheus периодически обращается к одной и той же конечной точке для проверки новых данных. Prometheus собирает данные из программного обеспечения, инструментированного клиентской библиотекой.
Например, приложение на NodeJS может настроить prom-client, чтобы легко предоставлять метрики по конечной точке, а Prometheus может регулярно собирать данные с этой конечной точки. Prometheus включает ряд других инструментов в наборе для инструментирования ваших приложений.
Prometheus как развёртывание
Первый раздел этого документа ввёл понятие «Prometheus как данные» и то, как организованы модель данных Prometheus и метрики. Второй раздел ввёл понятие «Prometheus как программное обеспечение», используемое для сбора, обработки и хранения метрик. В этом разделе описывается, как «Prometheus как данные» и «Prometheus как программное обеспечение» объединяются.
Рассмотрим следующий пример. Предположим, приложение ‘MyApp’ использует клиент Prometheus, чтобы предоставлять метрики. Один из подходов к сбору данных метрик — использовать в приложении URL, указывающий на конечную точку http://localhost:3000/metrics, которая выдаёт данные метрик Prometheus.
На следующем изображении показаны две метрики, связанные с этой конечной точкой. Текст HELP объясняет, что означает метрика, а текст TYPE указывает, какого она типа (в данном случае gauge). MyAppnodejs_active_request_total указывает число запросов (в данном случае 1). MyAppnodejs_heap_size_total_bytes указывает размер кучи в байтах. Здесь только два числа, потому что данные показывают значение на момент выборки данных.
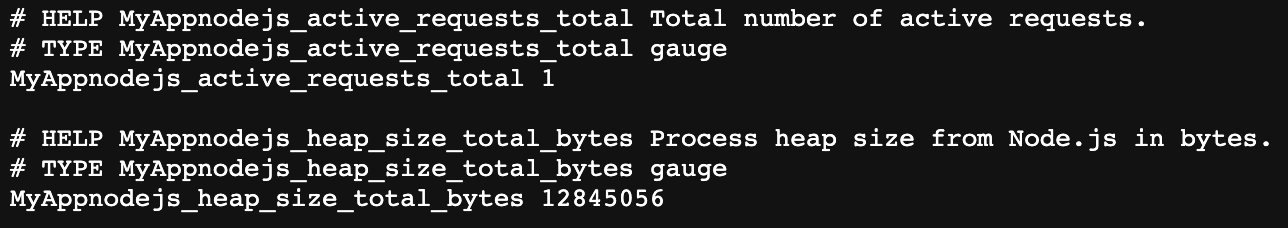
Метрики ‘MyApp’ доступны по HTTP-конечной точке, но как они попадают в Grafana, а затем на дашборд? Процесс записи и передачи показаний приложения или части инфраструктуры называется телеметрией. Телеметрия критически важна для наблюдаемости, так как помогает точно понять, что происходит в вашей инфраструктуре. Метрики, представленные ранее, например MyAppnodejs_active_requests_total, — это данные телеметрии.
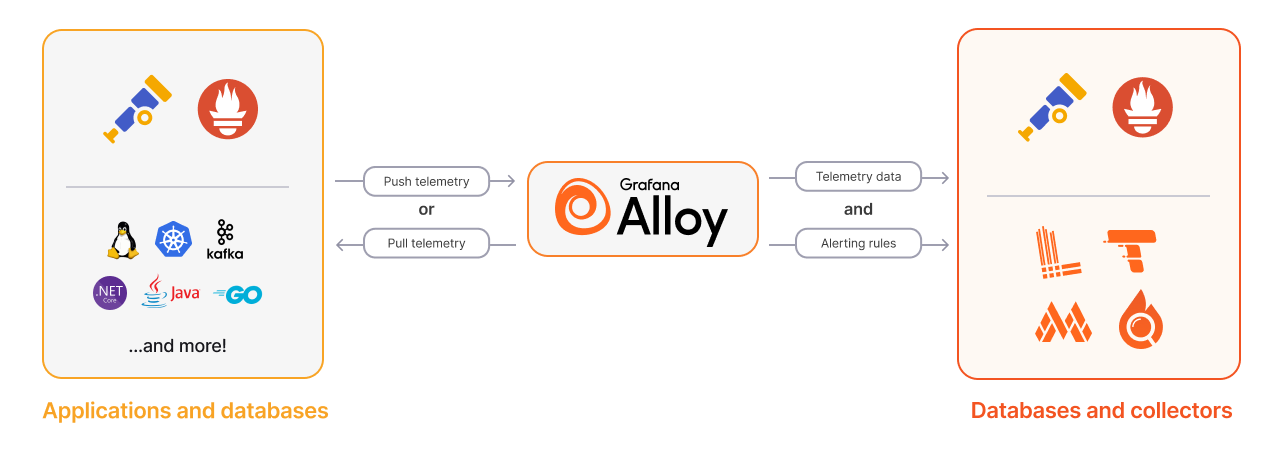
Чтобы доставить метрики в Grafana, вы можете использовать либо программное обеспечение Prometheus, либо Grafana Alloy для сбора метрик. Grafana Alloy собирает и пересылает данные телеметрии в развёртывания Grafana Stack с открытым исходным кодом, в Grafana Cloud или Grafana Enterprise, где ваши данные можно анализировать. Например, вы можете настроить Grafana Alloy так, чтобы он забирал данные из ‘MyApp’ каждые пять секунд и отправлял результаты в Grafana Cloud.
Данные метрик — лишь один из типов данных телеметрии; другие типы — это логи и трейсы. Использование Grafana Alloy может быть отличным вариантом для отправки данных телеметрии, так как по мере масштабирования ваших практик наблюдаемости для включения логов и трейсов, которые Grafana Alloy также поддерживает, у вас уже будет готовое решение.
На следующем изображении показано, как Grafana Alloy работает как посредник между ‘MyApp’ и Grafana Cloud.
Собираем всё вместе
Сочетание Prometheus и Grafana Alloy даёт вам контроль над метриками, которые вы хотите передавать, над тем, откуда они приходят и куда направляются. Как только данные попадают в Grafana, их можно хранить в базе данных Grafana Mimir. Дашборды Grafana состоят из визуализаций, наполняемых данными, запрошенными из источника данных Prometheus. Запрос PromQL фильтрует и агрегирует данные, предоставляя нужное вам понимание. Благодаря этим шагам мы прошли путь от необработанных чисел, сгенерированных программным обеспечением, в Prometheus, доставили их в Grafana, запросили через PromQL и визуализировали в Grafana.
Что дальше?
Теперь, когда вы понимаете, как работают метрики Prometheus, что вы будете создавать?
- Отличный следующий шаг — создать дашборд в Grafana и начать превращать необработанные данные телеметрии Prometheus в понимание того, что происходит с вашими сервисами и инфраструктурой.
- Ещё один хороший шаг — узнать о Grafana Mimir, который по сути является базой данных для данных Prometheus. Если вам интересно, как заставить это работать с большими объёмами метрик с множеством данных и быстрыми запросами, обратите внимание на Grafana Mimir.
- Если вы хотите работать с данными Prometheus в Grafana напрямую, обратитесь к документации источника данных Prometheus или к разделу Основы PromQL.