
When SLOs reduce alert noise
По мере роста вашей конфигурации оповещений в production не каждое оповещение работает так, как ожидалось. Иногда они срабатывают слишком часто или разрешаются немедленно, прежде чем кто-либо успевает отреагировать. Вы начинаете задаваться вопросом, не в самом ли оповещении проблема.
Когда это происходит, вашим инстинктом может быть настроить запрос или порог, а может, просто удалить его. Иногда оповещение говорит вам, что вы неправильно измеряете надёжность, и внедрение целей уровня обслуживания (SLO) может быть правильным ответом.
Это руководство охватывает три самых распространённых паттерна, где SLO могут помочь снизить шум оповещений и улучшить охват надёжности, и показывает, как распознать потребность в SLO в вашей конфигурации оповещений.
How SLOs differ from threshold alerts
Пороговые оповещения оценивают условие на своём интервале оценки, например каждые 5m, 30m, 1h.
Если результат запроса в этот момент пересекает порог, оповещение срабатывает. Оно продолжает находиться в сработавшем состоянии на следующей оценке, если условие всё ещё выполняется, или возвращается в нормальное состояние после разрешения.
В этом смысле состояние оповещения бинарно: сработало или не сработало.
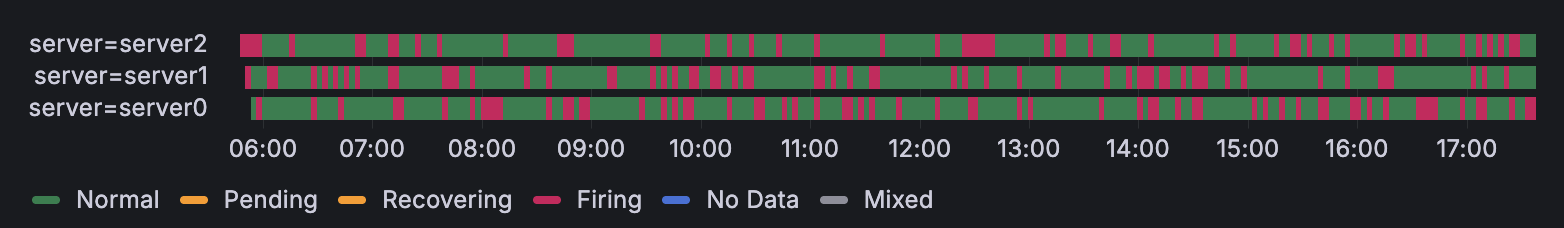
SLO в первую очередь сосредоточены не на том, здоров ли сервис прямо сейчас. Они измеряют, надёжен ли ваш сервис на протяжении длительного периода — недели или нескольких недель, а не в определённый момент времени. Например:
-
Оповещение спрашивает: за последние 10 минут ответили ли 50 % запросов менее чем за 3 с?
-
SLO задаёт похожий вопрос на более длинном окне: за последние 4 недели ответили ли 95 % запросов менее чем за 3 секунды?
Оповещения также могут использовать длительные периоды оценки, но они сбрасываются, когда сервис восстанавливается.
SLO отслеживают сбои относительно бюджета ошибок, даже когда сервис восстанавливается. Они записывают, сколько деградации накопилось, и сообщают, сколько сбоев ещё допустимо.
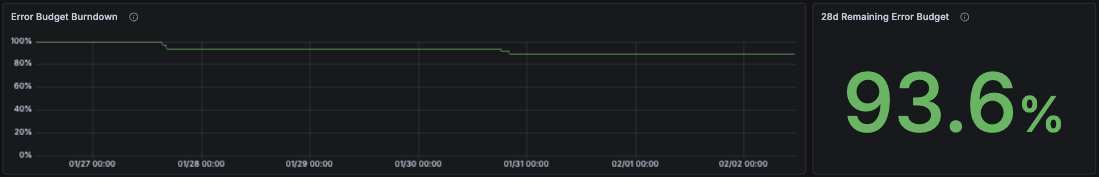
Другое ключевое отличие — в том, как работают оповещения SLO. Вместо срабатывания, когда бюджет ошибок исчерпан и цель нарушена, они срабатывают, когда цель под угрозой.
Оповещения SLO вызывают вас, когда система быстро деградирует, так что у вас есть время действовать до нарушения SLO.
SLO и пороговые оповещения дополняют друг друга. В некоторых случаях имеет смысл отслеживать один и тот же сигнал надёжности и в оповещениях, и в SLO: оповещения для немедленной реакции, а SLO для долгосрочной видимости. В других случаях правильным решением является перевод оповещений в SLO. Следующие случаи — самые распространённые ситуации, когда команды начинают внедрять SLO на основе существующих оповещений.
The alert has no actionable response
Оповещения должны быть действенными. Оповещение, на которое никто не реагирует, — это операционный шум. Если оповещение неизменно не вызывает никакой реакции, но метрика всё ещё важна для вашей команды, это проблема надёжности.
Эта метрика надёжности может указывать на состояние сервиса во времени. Её стоит отслеживать на операционных дашбордах, но она не предназначена для вызова немедленных действий.
Спросите команду: возьмём ли мы обязательство по цели относительно состояния этого сервиса и будем ли действовать, если производительность деградирует? Если ответ «да», SLO — правильный выбор.
На практике этот вопрос часто выявляет, действительно ли метрика измерима как индикатор уровня обслуживания (SLI).
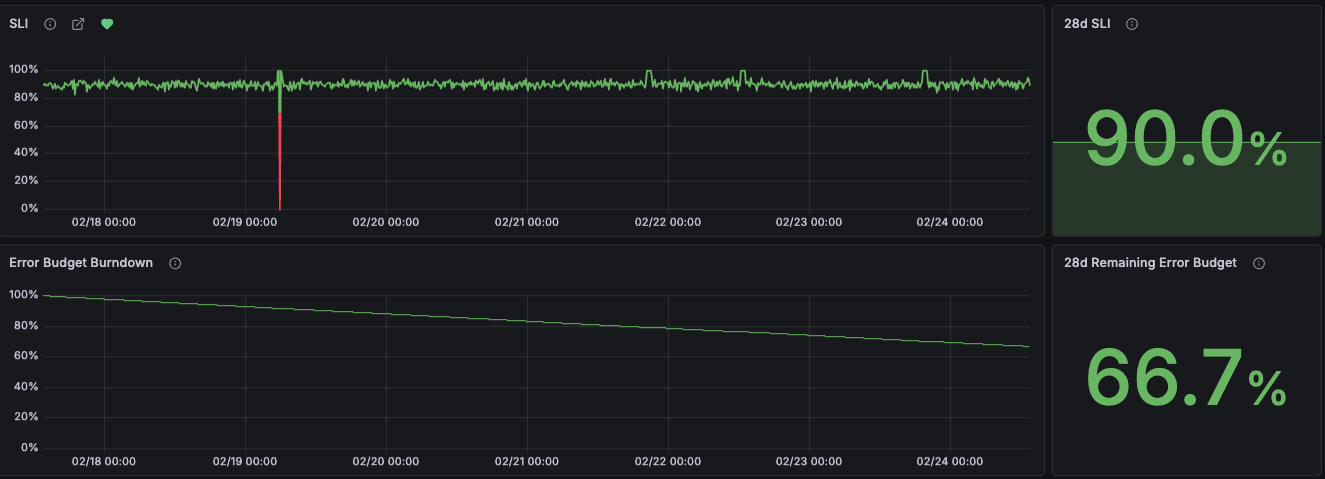
Определение цели SLO объединяет команду вокруг общей цели и определяет, когда накопленная деградация достаточно серьёзна, чтобы требовались действия. Это часто самая сложная часть. Ожидайте несколько итераций, прежде чем цель отразит реальность.
Иногда удаление оповещения — правильное решение, если нет обязательства или SLI, к которому можно привязать действительный SLO. Но если одна и та же метрика продолжает всплывать в разборах инцидентов разных команд, это другой сигнал, указывающий на общую проблему надёжности.
The alert reflects a shared reliability concern
Иногда несколько команд поддерживают оповещения по одной и той же метрике, ориентированной на пользователя, такой как время отклика сервиса, каждая применяя свои пороги и внутренние метрики для своих сервисов, но не имея цели для оценки сквозного пользовательского опыта.
Это иногда приводит к перекрывающимся оповещениям, покрывающим один и тот же сигнал.
Когда разные команды определяют свои собственные пороги для метрик производительности сервисов или пользовательского опыта, это выявляет общую проблему пользовательского опыта, которая не была выражена явно.
В других случаях SLO определяется бизнесом, например обязательством перед клиентом или соглашением об уровне обслуживания (SLA). SLO формализует его как общую цель, отслеживаемую относительно того, чего ожидают клиенты.
Прежде чем создавать общий SLO, команды должны договориться о чёткой принадлежности.
В обоих случаях часто происходит переход от внутренних метрик к метрикам надёжности, ориентированным на пользователя, как рекомендуется в лучшей практике отдавать приоритет симптомам, а не причинам.
Создание общего SLO не должно устранять существующие связанные оповещения. Это хороший момент, чтобы оценить, вызывают ли существующие оповещения немедленные действия. Если вы замечаете, что эти оповещения менее действенны, а лежащая в основе метрика надёжности лучше измеряется как SLO, то переведите существующее оповещение в SLO уровня команды.
SLO уровня команды — более безопасный вариант по умолчанию. Переходите к общему SLO только после того, как команды договорятся о принадлежности.
The alert fires on transient conditions
Оповещение срабатывает и разрешается без вмешательства человека — паттерн, обычно называемый дребезгом (flapping).

Лучшие практики оповещений рекомендуют настраивать дребезжащие оповещения, изменяя параметры правила оповещения, чтобы избежать обнаружения коротких всплесков и преходящих проблем. Настройка уменьшает шум, но может полностью убрать сигнал.

В этом случае дребезжащее оповещение выявило проблему надёжности. Отдельные срабатывания выглядят безобидно, но накопленная со временем деградация влияет на пользователей. Пороговое оповещение может маскировать эти ошибки.
Бюджет ошибок SLO отражает этот паттерн. Каждый преходящий сбой расходует долю бюджета, делая кумулятивное влияние видимым на протяжении окна SLO.
Этот паттерн не ограничивается дребезжащими оповещениями. Любое оповещение с допустимыми преходящими сбоями сталкивается с тем же компромиссом: настроить ради меньшего шума и потерять видимость, или оставить оповещение и научиться его игнорировать.
Отслеживание сигналов надёжности на дашбордах и оповещения на длительных периодах оценки могут быть решением. SLO подходят лучше: бюджет ошибок не сбрасывается и отслеживает каждый сбой в пределах окна SLO.
Conclusion
Не каждое оповещение нужно настраивать или заглушать, когда оно неэффективно. Некоторые измеряют что-то, что стоит отслеживать иначе.
Три распространённых паттерна сигнализируют о том, что оповещение готово стать SLO:
- Нет действенной реакции: сигнал указывает на надёжность сервиса, но не вызывает немедленных действий.
- Общая проблема надёжности: команды отслеживают похожие метрики, ориентированные на пользователя, но не имеют общей цели.
- Преходящие условия: кратковременные сбои часто игнорируются, но всё равно влияют на пользователей.
Во всех трёх случаях происходит переход от оценки порога за недавний период к оценке цели надёжности, отслеживаемой на длительном периоде. Это снижает операционный шум и фокусирует оповещения на том, соответствует ли ваш сервис своим целям надёжности. SLO не заменяют ваши существующие оповещения; они приносят отдельный метод измерения надёжности сервиса.
Чтобы начать, см. введение в SLO в Grafana Cloud.