
Handle missing data in Grafana Alerting
Отсутствующие данные, когда цель перестаёт сообщать данные метрик, могут быть одной из самых распространённых проблем при отладке оповещений. В cloud-native средах это происходит постоянно. Поды или узлы масштабируются вниз в соответствии со спросом, или целая задача тихо исчезает.
Когда это происходит, оповещения не срабатывают, и вы можете не заметить, что система перестала сообщать данные.
Иногда это просто нехватка данных от нескольких экземпляров. В других случаях это проблема связности, когда вся цель недостижима.
Это руководство охватывает различные сценарии, когда нижележащие данные отсутствуют, и показывает, как проектировать ваши оповещения для реагирования на такие случаи. Если вы отлаживаете недостижимый хост или сетевой сбой, см. также документацию по обработке ошибок связности.
No Data vs. Missing Series
Есть несколько распространённых причин, когда экземпляр перестаёт сообщать данные, аналогично ошибкам связности:
- Сбой хоста: Система недоступна, и Prometheus перестаёт собирать данные с цели.
- Временные сетевые сбои: Промежуточные ошибки сбора вызывают пропуски в данных.
- Изменения развёртывания: Вывод из эксплуатации, вытеснение подов Kubernetes или масштабирование вниз ресурсов.
- Эфемерные рабочие нагрузки: Метрики намеренно перестают сообщаться.
- И другое.
Первое, что нужно понять, — это разница между сбоем запроса (или ошибкой связности), No Data и Missing Series.
Запросы оповещений часто возвращают несколько временных рядов — по одному на экземпляр, под, регион или комбинацию меток. Это называется многомерным оповещением, то есть одно правило оповещения может вызывать несколько экземпляров оповещений (алертов).
Например, представьте записанную метрику http_request_latency_seconds, которая сообщает задержку в секунду по регионам, где развёрнуто приложение. Запрос возвращает один ряд на регион — например, region1 и region2 — и создаёт только два экземпляра оповещений. В этом сценарии вы можете столкнуться с:
- Connectivity Error, если запрос правила оповещения даёт сбой.
- No Data, если запрос выполняется успешно, но вообще не возвращает данных.
- Missing Series, если один или несколько конкретных рядов, которые ранее возвращали данные, отсутствуют, но другие ряды всё ещё возвращают данные.
В обоих случаях No Data и Missing Series запрос технически всё ещё «работает», но оповещение не сработает, если вы явно не настроите его для обработки этих ситуаций.
Следующие таблицы иллюстрируют оба сценария на предыдущем примере с оповещением, которое срабатывает, если задержка превышает 2 секунды в любом регионе: avg_over_time(http_request_latency_seconds[5m]) > 2.
Сценарий No Data: Запрос не возвращает данных ни для одного ряда:
Сценарий MissingSeries: Исчезает только конкретный ряд (region2):
В обоих случаях что-то сломалось молча.
Detect missing data in Prometheus
Prometheus не вызывает оповещения, когда запрос не возвращает данных. Он просто предполагает, что сообщать было нечего, как и при ошибках запросов. Отсутствующие данные не вызовут существующие оповещения, если вы явно не проверяете их наличие.
В Prometheus распространённый способ поймать отсутствующие данные — использовать функцию absent_over_time.
absent_over_time(http_request_latency_seconds[5m]) == 1
Это срабатывает, когда все ряды для http_request_latency_seconds отсутствуют в течение 5 минут — ловя случай No Data, когда исчезает вся метрика.
Однако absent_over_time() не может определить, какие конкретные ряды отсутствуют, поскольку он не сохраняет метки. Оповещение не скажет вам, какой ряд перестал сообщать данные, только что запрос не возвращает данных.
Если вы хотите проверять отсутствующие данные по региону или метке, вы можете указать метку в запросе оповещения следующим образом:
# Detect missing data in region1
absent_over_time(http_request_latency_seconds{region="region1"}[5m]) == 1

# Detect missing data in region2
absent_over_time(http_request_latency_seconds{region="region2"}[5m]) == 1
Но это плохо масштабируется. Ненадёжно иметь жёстко заданные запросы для каждого набора меток, особенно в динамических облачных средах, где экземпляры могут появляться или исчезать в любой момент.
Чтобы обнаруживать, когда конкретная цель исчезла, см. ниже раздел Evict alert instances for missing series с подробностями о том, как Grafana обрабатывает этот случай и как настроить обнаружение.
Manage No Data issues in Grafana alerts
Хотя Prometheus предоставляет функции, такие как absent_over_time(), для обнаружения отсутствующих данных, не все источники данных, доступные оповещениям Grafana — такие как Graphite, InfluxDB, PostgreSQL и другие — поддерживают аналогичную функцию.
Чтобы с этим справиться, Grafana Alerting реализует встроенную логику состояния No Data, так что вам не нужно обнаруживать отсутствующие данные с помощью запросов absent_*. Вместо этого вы можете настроить в параметрах правила оповещения, как оповещения ведут себя, когда данные не возвращаются.
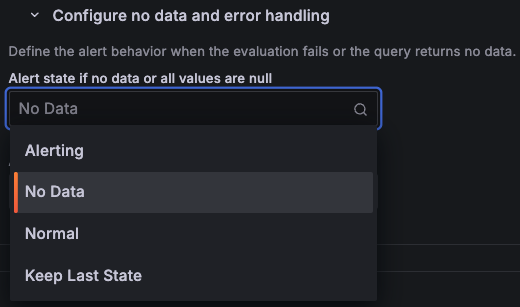
Как и в случае обработки ошибок, Grafana по умолчанию вызывает специальное оповещение No data и позволяет управлять этим поведением. В разделе Configure no data and error handling нажмите Alert state if no data or all values are null и выберите один из следующих вариантов:
-
No Data (по умолчанию): Вызывает новое оповещение
DatasourceNoData, трактуя No data как отдельную проблему. -
Alerting: Переводит каждый существующий экземпляр оповещения в состояние
Alerting, когда данные исчезают. -
Normal: Игнорирует отсутствующие данные и переводит все экземпляры в состояние
Normal. Полезно при получении промежуточных данных, например от экспериментальных сервисов, спорадических действий или периодических отчётов. -
Keep Last State: Оставляет оповещение в его предыдущем состоянии до возвращения данных. Это распространено в средах, где краткие пропуски метрик происходят регулярно, например при нестабильных экспортёрах или в шумных средах.
![A screenshot of the `Configure no data handling` option in Grafana Alerting.]()
Manage DatasourceNoData notifications
Когда Grafana вызывает оповещение NoData, он создаёт отдельный экземпляр оповещения, отличный от исходного экземпляра оповещения. Эти оповещения ведут себя по-другому:
- Они используют выделенный
alertname: DatasourceNoData. - Они не наследуют все метки от исходных экземпляров оповещений.
Из-за этого оповещения DatasourceNoData могут требовать отдельной конфигурации для обработки их уведомлений. Общие рекомендации см. в разделе
Уменьшение избыточных оповещений DatasourceError — аналогичные практики могут применяться и к оповещениям NoData.
Evict alert instances for missing series
MissingSeries возникает, когда исчезает только часть рядов, но не все. Этот случай тонкий, но важный.
Grafana помечает отсутствующие ряды как stale после двух интервалов оценки и запускает процесс удаления экземпляра оповещения. Вот что происходит «под капотом»:
- Экземпляры оповещений с отсутствующими данными сохраняют своё последнее состояние в течение двух интервалов оценки.
- Если данные всё ещё отсутствуют после этого:
- Grafana добавляет аннотацию
grafana_state_reason: MissingSeries. - Экземпляр оповещения переходит в состояние
Normal. - Отправляется уведомление о разрешении, если оповещение ранее срабатывало.
- Экземпляр оповещения удаляется из интерфейса Grafana.
- Grafana добавляет аннотацию
Если экземпляр оповещения становится устаревшим, вы найдёте его в
истории оповещений как Normal (Missing Series) до того, как он исчезнет. Эта таблица показывает процесс удаления из предыдущего примера:
Why doesn’t MissingSeries match No Data behavior?
В динамических средах, таких как группы автомасштабирования, эфемерные поды, spot-инстансы, ряды естественным образом появляются и исчезают. MissingSeries обычно сигнализирует об изменениях инфраструктуры или развёртывания.
По умолчанию No Data вызывает оповещение, чтобы указать на потенциальную проблему.
Процесс удаления для MissingSeries разработан так, чтобы предотвратить дребезг оповещений, когда под или экземпляр исчезает, уменьшая шум оповещений.
В средах с частыми событиями масштабирования расставляйте приоритеты оповещений на основе симптомов над отдельными инфраструктурными сигналами и используйте агрегированные оповещения, если вам явно не нужно отслеживать отдельные экземпляры.
Handle MissingSeries notifications
Устаревший экземпляр оповещения вызывает уведомление о разрешении, если он переходит из сработавшего состояния (такого как Alerting, No Data или Error) в Normal, и
аннотация grafana_state_reason установлена в MissingSeries, чтобы указать, что оповещение не было разрешено восстановлением, а было удалено из-за исчезновения данных ряда.
Распознавание этих уведомлений помогает обрабатывать их должным образом. Например:
- Отображайте аннотацию
grafana_state_reason, чтобы чётко идентифицировать оповещения MissingSeries. - Или используйте аннотацию
grafana_state_reason, чтобы обрабатывать эти оповещения иначе.
Также просматривайте эти уведомления, чтобы подтвердить, сломалось ли что-то или оповещение было ненужным. Чтобы уменьшить шум:
- Заглушайте или отключайте оповещения во время планового обслуживания или развёртываний.
- Настройте правила оповещения так, чтобы не срабатывать на ряды, которые, как вы ожидаете, будут появляться и исчезать, и используйте вместо этого агрегированные оповещения.
Detect missing series in Prometheus
Ранее был пример того, как обнаруживать отсутствующие данные для конкретной метки, такой как region:
# Detect missing data in region1
absent_over_time(http_request_latency_seconds{region="region1"}[5m]) == 1

# Detect missing data in region2
absent_over_time(http_request_latency_seconds{region="region2"}[5m]) == 1
Однако этот подход плохо масштабируется, поскольку требует жёсткого задания всех возможных значений region.
В качестве альтернативы вы можете создать правило оповещения, которое динамически обнаруживает отсутствующие ряды, используя функцию present_over_time:
present_over_time(http_request_latency_seconds{}[24h])
unless
present_over_time(http_request_latency_seconds{}[10m])
Или, если вы хотите группировать по метке, такой как region:
group(present_over_time(http_request_latency_seconds{}[24h])) by (region)
unless
group(present_over_time(http_request_latency_seconds{}[10m])) by (region)
Этот запрос находит регионы (или другие цели), которые присутствовали в любой момент за последние 24 часа, но не присутствовали за последние 10 минут. Затем правило оповещения вызывает экземпляр оповещения для каждого отсутствующего региона. Вы можете применить ту же технику к любой метке или измерению цели.
Conclusion
Отсутствующие данные — не всегда сбой. Это распространённый сценарий в динамических средах, когда определённые цели перестают сообщать данные.
Grafana Alerting обрабатывает различные сценарии автоматически. Вот как об этом думать:
- Понимайте уведомления
DatasourceNoDataиMissingSeries, поскольку они ведут себя не как обычные оповещения. - Используйте варианты обработки No Data в Grafana, чтобы определить, что происходит, когда запрос ничего не возвращает.
- Когда NoData не является проблемой, рассмотрите переписывание запроса так, чтобы он всегда возвращал данные — например, в Prometheus используйте
your_metric_query OR on() vector(0), чтобы возвращать0, когдаyour_metric_queryничего не возвращает. - Используйте
absent_over_time()илиpresent_over_timeв Prometheus, чтобы обнаруживать, когда метрика или цель исчезает. - Если данные часто отсутствуют из-за задержек сбора, используйте техники учёта задержек данных:
- Настройте параметр запроса Time Range в Grafana, чтобы оценивать немного позади реального времени (например, задайте To как
now-1m), чтобы учесть опоздавшие точки данных. - В Prometheus вы можете использовать
last_over_time(metric_name[10m]), чтобы выбрать самый последний сэмпл в заданном окне.
- Настройте параметр запроса Time Range в Grafana, чтобы оценивать немного позади реального времени (например, задайте To как
- Не оповещайте по каждому экземпляру по умолчанию. В динамических средах лучше агрегировать и оповещать по симптомам — если только отсутствие отдельного экземпляра напрямую не влияет на пользователей.
- Если вы получаете слишком много шума от исчезающих данных, рассмотрите настройку оповещений, использование
Keep Last Stateили маршрутизацию этих оповещений иначе. - Для проблем связности, связанных со сбоями запросов оповещений, см. сопутствующее руководство: Обработка ошибок связности в Grafana Alerting.